

휴머노이드가 사람 동작 29개만 보고 상자를 나를 수 있었던 이유 : 로코매니퓰레이션 DiPLO 논문 리뷰
2분1180
사람 동작 29개만 보여주고 휴머노이드에게 상자 나르기를 가르칠 수 있을까요?
휴머노이드가 물체를 들고 걸어가 정해진 자리에 내려놓는 일을 로코매니퓰레이션(Loco-manipulation)이라고 합니다. 걷기와 집기를 따로 잘한다고 둘을 함께 해내는 건 아닙니다. 독일 뮌헨공대(TUM) 연구진이 발표한 DiPLO는 디퓨전 모델이 전신 움직임을 계획하고 강화학습으로 배운 트래커가 그 계획을 실행하는 구조로 이 문제를 풉니다. 2.7분 분량의 사람 동작에서 출발해 유니트리 G1 실기체로 상자를 옮긴 이 논문을 빅웨이브로보틱스 송준봉 CTO가 해설합니다.
CTO'S PICK · 08
송준봉 | 빅웨이브로보틱스 CTO
빅웨이브로보틱스의 기술 총괄. 매달 주목할 만한 휴머노이드·피지컬 AI 논문을 한 편씩 골라 연구자와 실무자의 눈높이에서 해설합니다.
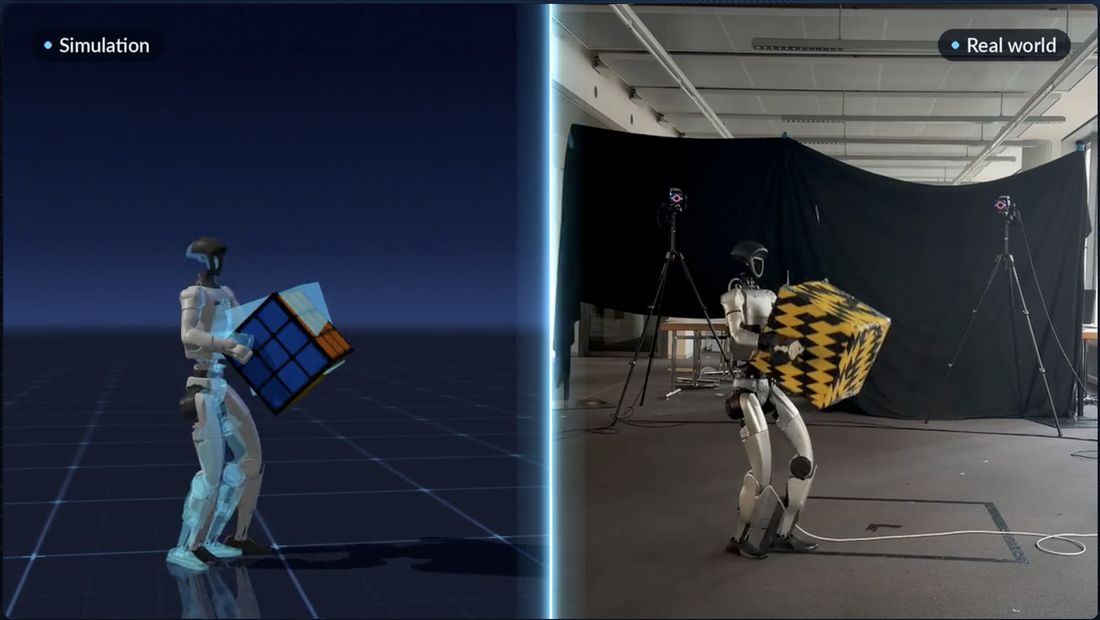
시뮬레이션에서 학습한 플래너와 트래커를 추가 학습 없이 유니트리 G1에 그대로 옮겼습니다 (출처: DiPLO 프로젝트 페이지)
01들어가며
휴머노이드 로코매니퓰레이션은 왜 어려울까?
사람은 무거운 상자를 들면 자기도 모르게 보폭을 줄이고 허리를 세웁니다. 상자가 몸 앞으로 나오는 순간 무게중심이 바뀌기 때문이죠. 휴머노이드도 똑같습니다. 팔이 움직이면 균형이 흔들리고 물체를 잡는 순간 다리에 걸리는 힘이 달라집니다. 걷기 정책과 집기 정책을 따로 만들어 이어 붙이는 것만으로는 부족한 이유입니다.
지금까지는 두 가지 방법이 주로 쓰였습니다. 사람 동작을 로봇 관절에 맞게 옮기는 리타게팅(Retargeting)과 시뮬레이션에서 전신 제어 정책을 강화학습으로 처음부터 배우는 방법입니다. 그런데 리타게팅한 동작은 로봇이 실제로 따라 하기 어려운 경우가 많습니다. 복잡한 전신 작업을 강화학습으로 처음부터 가르치려면 학습 시간과 시뮬레이션 환경 설계 부담도 큽니다.
DiPLO(Self-distilled Diffusion Planning for Loco-manipulation)는 두 방법의 장점을 이어 붙였습니다. 처음 학습에 쓴 사람 동작은 29개이고 다 합쳐도 2.7분이 안 됩니다. 연구진은 이 데이터를 물리적으로 가능한 동작 7,184개로 늘린 뒤 디퓨전 모델로 움직임을 계획하고 강화학습으로 다듬어 작업 성공률을 끌어올렸습니다.
🔍 CTO가 이 논문을 고른 이유
- 적은 데이터로 큰 움직임: 사람 동작 29개를 물리적으로 실행 가능한 모션 7,184개로 늘렸습니다.
- 디퓨전과 강화학습의 역할 분담: 디퓨전 모델이 미래 전신 모션을 계획하고 강화학습 트래커가 실제 로봇에서 실행합니다.
- 자기 증류와 후속 학습: 처음에 쓰던 상세한 동작 가이드를 마지막에는 빼고 목표만 보고 움직이게 만들었습니다.
본론에 들어가기 전에 DiPLO가 거치는 4단계를 먼저 보면 흐름이 잡힙니다.
| 단계 | 하는 일 | 생존율 | 작업 성공률 |
|---|---|---|---|
| ① 데이터 확장 | 사람 동작 29개를 물리적으로 가능한 동작 7,184개로 | - | - |
| ② 사전학습 | 선생님 모델 : 레퍼런스 동작을 함께 넣고 평가 | 96.5% | 51.9% |
| 학생 모델 : 같은 모델에서 레퍼런스만 빼고 평가 | 57.7% | 45.4% | |
| ③ SD:DPO | 레퍼런스 없는 학생이 다시 안정적으로 움직이도록 자기 증류 | 100% | 55.1% |
| ④ DA:PPO | 실제 실행 결과를 보상으로 플래너를 강화학습 | 99.5% | 98.8% |
시뮬레이션 Pick-Carry-Place 작업 기준입니다. 작업 성공률은 넘어지지 않고 끝까지 마친 회차 가운데 목표 위치에 맞게 내려놓은 비율입니다 (출처: DiPLO 논문 Table V)
02DiPLO 핵심 ① 데이터
사람 동작 29개를 7,184개로 : 모션 리타게팅과 데이터 증강
사람 동작을 로봇에 옮길 때는 보통 IK(Inverse Kinematics, 역기구학)로 손과 발의 위치를 맞춥니다. 그런데 모양이 맞는다고 로봇이 그 동작을 해낼 수 있는 건 아닙니다. 사람과 로봇은 관절 구조도 무게 배분도 다르니까요. 리타게팅한 동작을 그대로 쓰면 이런 문제가 생깁니다.
- 무게중심이 발바닥 바깥으로 벗어나 넘어진다
- 발이 바닥을 제대로 딛지 못하고 미끄러진다
- 물체를 들고 이동하는 동안 손과 상자의 움직임이 어긋난다
- 관절 속도와 가속도와 토크 한계를 넘어선다
DiPLO는 여기서 SBTO(Sampling-Based Trajectory Optimization)를 씁니다. 선행 연구 DynaRetarget에서 리타게팅 동작을 물리적으로 가능한 동작으로 다듬는 데 쓰던 방법인데 DiPLO는 이것을 데이터를 늘리는 용도로 다시 활용했습니다. 후보 궤적을 여러 개 뽑아 보고 최적화를 반복하며 로봇이 실제로 해낼 수 있는 궤적을 찾아가는 방식입니다.
같은 상자 운반이라도 로봇의 출발 위치와 자세를 바꾸고 처음 관절 상태와 상자의 위치·방향을 바꿔 다시 풀면 서로 다른 동작이 나옵니다. 최적화에 쓰는 샘플링 시드만 바꿔도 결과가 달라지죠. 기존 관절값에 노이즈를 조금 섞는 흔한 증강과 달리 로봇의 동역학과 접촉 조건을 고려해 실행 가능한 동작을 새로 최적화한다는 점이 다릅니다.
여기에 대칭 증강(Symmetry Augmentation)을 더했습니다. 왼쪽으로 옮기는 동작을 거울에 비추면 오른쪽으로 옮기는 동작이 됩니다. 상자를 90도씩 돌리면 같은 동작으로 다른 배치를 만들 수 있고요.
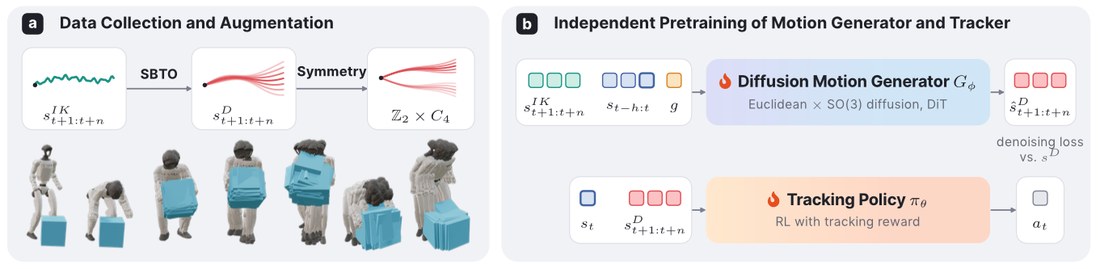
(a) 리타게팅 동작 → SBTO → 대칭 증강으로 데이터를 늘리고 (b) 디퓨전 모션 생성기와 트래커를 각각 사전학습합니다 (출처: DiPLO 논문)
| 데이터 생성 단계 | 모션 수 |
|---|---|
| 초기 리타게팅 데이터 | 29개 |
| SBTO로 동작 변형 | 898개 |
| 대칭 증강 적용 | 7,184개 |
💡 7,184개를 새로 찍은 건 아닙니다
원래 데이터는 공개 데이터셋 OmniRetarget에서 가져온 로봇과 물체의 동작 29개입니다. 이것을 궤적 최적화로 다시 풀고 거울에 비춰 만든 것이 7,184개죠. 실제 로봇을 움직여 모든 동작을 모으지 않아도 학습 데이터의 다양성을 확보할 수 있다는 뜻입니다.
연구진은 두 증강이 성능에 주는 영향도 따로 비교했습니다. SBTO만 쓴 쪽의 생존율은 92.3%로 대칭 증강만 쓴 쪽(90.7%)보다 조금 높았고 둘을 함께 쓰자 96.5%까지 올라갔습니다. 겉모양만 다양하게 만드는 것보다 로봇이 실제로 해낼 수 있는 동작을 늘리는 쪽이 더 중요하다는 결과입니다.
29개가 7,184개로 늘었다는 숫자보다 그 방법에 의미가 있습니다. 적은 데이터에서 출발해도 물리 조건을 따지는 최적화와 대칭 증강을 묶으면 휴머노이드 학습에 필요한 동작의 다양성을 체계적으로 만들 수 있다는 점입니다. 사람 없이 시뮬레이션으로 학습 데이터를 만드는 다른 접근은 4편 LEGS 리뷰에서 다뤘습니다.
03DiPLO 핵심 ② 모델 구조
디퓨전 모델은 로봇의 움직임을 어떻게 계획할까?
DiPLO는 두 모델이 함께 움직입니다. 앞으로의 전신 움직임을 그리는 디퓨전 모션 플래너(Diffusion Motion Planner)와 그 계획을 실제 로봇에서 실행하는 강화학습 전신 트래커(Whole-body Tracker)입니다. 내비게이션이 앞길을 안내하면 운전자가 도로 사정에 맞춰 핸들을 조금씩 조정하는 것과 비슷합니다.
노이즈에서 1.28초의 움직임을 꺼내다
디퓨전 모델은 이미지·영상 생성에서 널리 쓰는 생성 모델입니다. 원본 데이터에 노이즈를 조금씩 섞어 알아볼 수 없게 만든 뒤 그 과정을 거꾸로 되돌리는 법을 배웁니다. 이미지 생성에서는 노이즈에서 그림을 꺼내고 DiPLO에서는 노이즈에서 로봇의 미래 움직임을 꺼냅니다.
로봇이 상자를 들고 오른쪽으로 가야 하는 상황을 생각해 보겠습니다. 플래너는 무작위에 가까운 동작에서 출발해 10번의 디노이징을 거치며 관절과 상자의 움직임을 점점 구체적으로 만듭니다. 한 번에 만드는 길이는 64프레임입니다. 트래커 기준 주파수인 50Hz로 따지면 약 1.28초죠. 다음 관절 명령 하나가 아니라 앞으로 1초 남짓의 흐름을 먼저 그리는 셈입니다. 확률적으로 생성하기 때문에 같은 목표에도 여러 가지 움직임을 낼 수 있습니다.
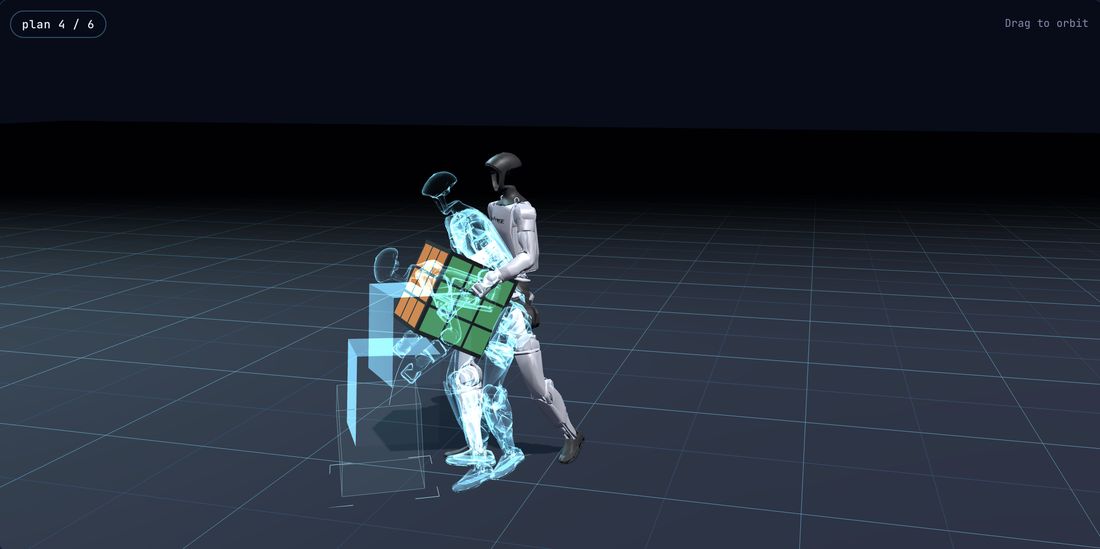
반투명한 로봇과 상자가 플래너가 그린 다음 움직임입니다 (출처: DiPLO 프로젝트 페이지)
플래너가 만드는 데이터에는 관절 위치만 들어 있지 않습니다. 로봇 몸통(Root)은 지도 위의 절대 좌표 대신 바닥에서 얼마나 이동했는지와 방향을 얼마나 틀었는지로 나타내고 여기에 몸통 높이와 기울기를 더합니다. 29개 관절의 위치와 상자의 위치·방향까지 이 모든 정보가 하나의 표현에 함께 담깁니다. 팔을 어떻게 뻗을지만 정하는 게 아니라 걷고 균형을 잡고 물체를 옮기는 일을 하나의 계획 문제로 다루는 겁니다. 이 계산은 트랜스포머를 디노이징 네트워크로 쓰는 DiT(Diffusion Transformer)가 맡습니다.
회전은 숫자처럼 다루면 안 된다 : SO(3) 디퓨전
위치는 숫자 그대로 노이즈를 섞어도 되지만 회전은 사정이 다릅니다. 시계 바늘로 생각하면 쉽습니다. 350도와 10도는 숫자로는 340만큼 차이 나지만 실제로는 20도밖에 떨어져 있지 않죠. 3차원 회전은 이보다 훨씬 복잡한 구조를 갖습니다.
DiPLO는 3차원에서 가능한 모든 회전을 담는 수학적 공간인 SO(3)의 구조에 맞춰 회전 데이터에 노이즈를 넣고 되돌립니다. 위치는 일반적인 방식으로 처리하고 회전은 SO(3) 방식으로 따로 처리한 것이죠. 차이는 꽤 컸습니다.
| 회전 표현 방식 | 생존율 | 작업 성공률 |
|---|---|---|
| SO(3) 디퓨전 | 96.5% | 51.9% |
| 일반(Euclidean) 디퓨전 | 85.9% | 46.4% |
출처: DiPLO 논문 Table II
데이터를 많이 넣는 것만큼 데이터의 물리적·기하학적 성격에 맞는 표현을 고르는 일도 중요하다는 걸 보여주는 결과입니다.
트래커는 정답을 새로 만들지 않고 차이만 고친다
시뮬레이션에서 완벽했던 계획도 실제 로봇에서는 그대로 재현되지 않습니다. 외부 충격이 들어오고 지면과의 접촉이 달라지고 관절 제어 오차가 쌓이기 때문입니다. 이 차이를 메우는 게 트래커입니다.
트래커는 강화학습 알고리즘 PPO(Proximal Policy Optimization)로 학습합니다. PPO는 한 번 업데이트할 때 정책이 너무 크게 바뀌지 않게 막아서 학습을 안정적으로 만드는 방법입니다. 트래커는 현재 로봇 상태와 직전 행동과 앞으로의 레퍼런스 동작을 입력으로 받습니다. 그리고 관절 목표값을 처음부터 다시 만들지 않고 플래너가 그린 관절 위치에 더할 보정값(Residual)만 냅니다. 계획에 보정값을 더한 목표 관절 위치는 PD 제어기가 따라갑니다.
덕분에 플래너는 전체 흐름을 계획하는 데 집중하고 트래커는 실제 몸의 상태와 오차를 챙깁니다. 연구진은 작업마다 제어기를 따로 만들지 않고 여러 전신 동작을 두루 따라가는 범용 트래커(Generalist Tracker) 하나를 학습했습니다.
왜 계획과 실행을 나눴을까?
연구진은 디퓨전 모델이 관절 제어 명령을 직접 내는 방식과도 비교했습니다. 같은 조건에서 계획과 실행을 나눈 구조가 가장 좋았습니다.
| 방식 | 생존율 | 작업 성공률 |
|---|---|---|
| 모션 디퓨전 + RL 트래커 (DiPLO) | 96.5% | 51.9% |
| 액션 디퓨전 (관절 명령 직접 생성) | 87.5% | 45.3% |
| 상태·액션 동시 디퓨전 | 58.2% | 8.2% |
출처: DiPLO 논문 Table III
차이는 속도에서 나옵니다. 디퓨전은 디노이징을 여러 번 거쳐야 해서 실기체에서 최대 약 12.5Hz로 돕니다. 넘어지지 않으려면 훨씬 빠른 피드백이 필요하죠. DiPLO는 트래커를 50Hz로 돌리고 PD 제어기는 200Hz로 돌립니다. 플래너가 새 계획을 만드는 동안에도 트래커는 이미 받은 계획을 실행하면서 실제 상태에 맞춰 계속 보정합니다. 시뮬레이션에서는 64프레임 가운데 앞 56프레임을 실행한 뒤 새 계획으로 넘어가고 실기체에서는 새 계획이 도착할 때까지 지금 계획을 이어서 실행합니다. 새 계획은 그사이 실제로 측정한 로봇 상태를 바탕으로 다시 만들어지니 추종 오차도 자연스럽게 반영됩니다.
| 구성 | 주기 | 맡은 일 |
|---|---|---|
| 디퓨전 플래너 | 최대 약 12.5Hz | 앞으로 1.28초의 전신·물체 움직임 계획 |
| RL 트래커 | 50Hz | 계획과 실제 상태의 차이를 보정 |
| PD 제어기 | 200Hz | 관절 목표 위치 추종 |
고수준 계획은 조금 느려도 괜찮지만 균형 제어와 피드백은 빨라야 하는 휴머노이드의 특성에 맞춘 계층형 구조입니다. 7편 HAMSTER에서는 VLM이 경로를 그리고 하위 정책이 실행했다면 DiPLO는 디퓨전이 전신 모션을 그리고 RL 트래커가 실행합니다. 디퓨전 추론 속도가 실제 작업 속도에 어떤 영향을 주는지는 5편 RACE 리뷰에서도 다뤘습니다.
04DiPLO 핵심 ③ 후속 학습
레퍼런스 없이 스스로 움직이게 : 자기 증류와 강화학습 포스트 트레이닝
DiPLO의 가장 중요한 기여는 사전학습한 플래너를 그대로 쓰지 않고 두 단계의 후속 학습(Post-training)을 거쳐 스스로 계획하는 플래너로 키운다는 점입니다. 첫 번째는 SD:DPO(Self-Distillation Diffusion Policy Optimization), 두 번째는 DA:PPO(Diffusion-Augmented Proximal Policy Optimization)입니다.
SD:DPO : 해설지 없이 같은 문제를 풀게 하다
사전학습 플래너는 로봇의 상태 이력과 목표에 더해 IK로 리타게팅한 레퍼런스 동작도 입력받습니다. 어떻게 움직이면 되는지 알려주는 가이드인 셈이라 데이터가 적어도 빨리 배웁니다. 문제는 실제로 쓸 때입니다. 새 목표가 생길 때마다 거기 맞는 사람 동작을 찾아 리타게팅해야 하고 그 동작의 품질에 따라 성능이 흔들립니다. 그렇다고 처음부터 레퍼런스 없이 따로 사전학습한 모델(No-prior)은 생존율이 46.9%에 그쳤습니다. 레퍼런스를 쓰며 사전학습한 뒤 레퍼런스만 빼고 평가한 학생 모델은 57.7%였고요. 처음부터 가이드 없이 배우는 것보다 가이드로 기본기를 먼저 익힌 다음 의존을 떼어내는 쪽이 더 나은 출발점이라는 뜻이죠.
SD:DPO는 같은 사전학습 모델에서 출발한 선생님과 학생을 씁니다. 선생님은 해설지(레퍼런스 동작)를 보고 문제를 풀고 학생은 해설지 없이 로봇의 상태 이력과 물체의 목표 정보만 보고 같은 문제를 풉니다. 두 쪽에 똑같이 노이즈 섞인 동작을 넣고 선생님이 노이즈를 걷어내는 방향을 학생이 따라가도록 학습합니다. 선생님은 학습이 진행되는 동안 학생 가중치의 지수이동평균(EMA)으로 조금씩 갱신됩니다. 정답 동작을 베끼는 게 아니라 정답에 다가가는 방법을 물려받는 것이죠.
학생은 실제 트래커와 함께 시뮬레이션에서 움직이며 겪는 상태로도 학습합니다. 데이터 속 이상적인 상황만이 아니라 실제로 움직일 때 생기는 오차와 낯선 상태를 경험하는 겁니다. 그 결과 학생은 레퍼런스 동작 없이 로봇의 상태 이력과 물체의 목표 정보만으로 미래 움직임을 만들 수 있게 됩니다. 빠지는 건 레퍼런스 동작 입력이고 로봇의 상태 정보는 그대로 들어갑니다.
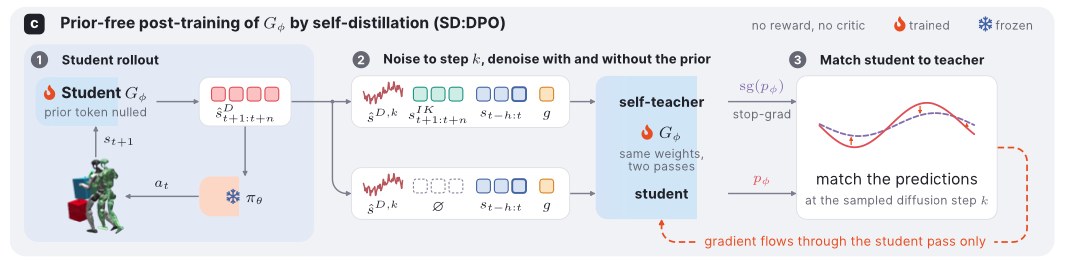
동일한 사전학습 모델에서 출발한 선생님과 학생이 레퍼런스 유무에 따라 각각 움직임을 예측하고 학생을 선생님의 예측에 맞춥니다. 선생님은 학습 중 학생 가중치의 지수이동평균(EMA)으로 갱신됩니다 (출처: DiPLO 논문)
DA:PPO : 실제 실행 결과로 움직임을 다시 배우다
넘어지지 않고 움직이는 것과 일을 해내는 것은 다릅니다. 상자를 들고 잘 걸어가도 목표 위치에 정확히 내려놓지 못하면 실패니까요. SD:DPO만으로는 이 둘을 모두 챙기기 어렵습니다. DA:PPO는 플래너가 그린 동작을 트래커가 시뮬레이션에서 실제로 실행해 보고 그 결과를 보상으로 평가해 플래너를 강화학습으로 다듬습니다.
보상은 두 가지를 비교했습니다. 하나는 IK로 리타게팅한 동작에 얼마나 가깝게 움직였는지를 보는 모션 추종 보상(r_kin)이고 다른 하나는 목표에 얼마나 다가갔는지에 생존 보너스를 더한 목표 접근 보상(r_goal)입니다. 작업 성공률은 각각 96.4%와 92.9%였고 논문의 주요 실험에는 r_kin을 썼습니다 (논문 Table IV).
여기서 헷갈리기 쉬운 부분이 있습니다. 완성된 플래너는 실행할 때 레퍼런스 동작을 입력받지 않지만 학습 중 점수를 매길 때는 IK 레퍼런스를 씁니다. 실행 단계에서 가이드를 빼는 것과 학습 단계에서 채점 기준으로 쓰는 건 별개의 문제죠. 레퍼런스 동작이 없는 새 목표라면 r_goal 같은 목표 접근 보상을 쓸 수 있다고 연구진은 덧붙였습니다.
일반적인 PPO는 행동 하나에 보상 하나를 매깁니다. 그런데 디퓨전은 동작 하나를 만들려고 디노이징을 여러 번 거치죠. DA:PPO는 디노이징 단계 하나하나를 강화학습의 의사결정으로 봅니다. 실행 보상은 마지막 디노이징 단계에 주어지고 벨만 재귀(Bellman Recursion)를 따라 앞선 디노이징 단계까지 거슬러 전달됩니다. 결승선에서 받은 기록이 앞 구간 주자들의 평가에도 반영되는 이어달리기와 비슷하죠. 실행 결과가 좋았다면 그 동작을 만든 계획 과정 전체가 그쪽으로 조금씩 학습되는 겁니다.
이때 트래커는 고정하고 플래너만 학습합니다. 하위 제어기를 계속 바꾸지 않고 지금의 트래커가 잘 따라갈 수 있는 움직임을 플래너가 만들도록 하는 설계입니다. 여기에 최대 엔트로피 강화학습(Maximum Entropy RL)을 더해 성공한 동작 하나만 반복하지 않고 여러 움직임을 탐색하게 했습니다. 상자를 들고 옮기는 방법도 보폭과 자세에 따라 여러 가지니까요.
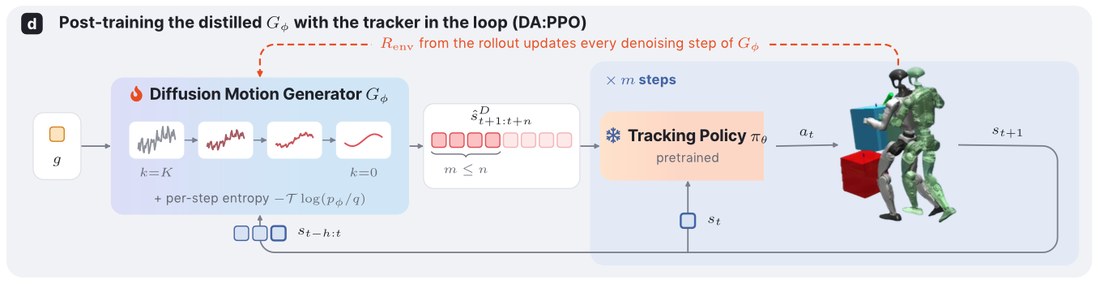
트래커(❄ 고정)가 실행한 결과로 보상을 매기고 그 신호로 디퓨전 생성기의 디노이징 과정 전체를 학습시킵니다 (출처: DiPLO 논문)
플래너와 트래커 중 무엇을 고쳐야 할까?
연구진은 플래너를 강화학습으로 고치는 방식과 트래커를 추가 학습하는 방식도 비교했습니다.
| 학습 방식 | 생존율 | 작업 성공률 |
|---|---|---|
| 사전학습 플래너 + 사전학습 트래커 | 96.8% | 51.9% |
| 사전학습 플래너 + 트래커 추가 학습 | 99.5% | 89.3% |
| 플래너 강화학습 + 트래커 고정 | 100% | 96.5% |
출처: DiPLO 논문 Table VI. 같은 사전학습 모델이지만 이 비교에서는 생존율이 96.8%로 따로 측정돼 다른 표의 96.5%와 조금 다릅니다
트래커만 추가 학습해도 작업 성공률이 51.9%에서 89.3%로 크게 오릅니다. 그래도 트래커를 고정하고 플래너를 고친 쪽이 96.5%로 더 높았습니다. 로봇이 아무리 정확히 따라가도 처음 그린 계획이 목표에서 벗어나 있으면 한계가 있다는 뜻입니다.
순서도 중요했습니다. 처음부터 레퍼런스 없이 사전학습한 모델(No-prior)에 바로 강화학습을 걸면 작업 성공률이 32.2%에서 67.0%까지만 오릅니다. 레퍼런스로 기본기를 익힌 학생이 자기 증류를 먼저 거쳐야 98.8%가 나옵니다. 강화학습에서 보상을 어떻게 설계하느냐가 왜 중요한지는 2편 SkillBlender 리뷰에서 자세히 다뤘습니다.
05실험 결과
유니트리 G1은 실제로 상자를 옮겼을까?
결과를 보기 전에 두 지표의 차이부터 짚고 가겠습니다.
📏 생존율과 작업 성공률은 다릅니다
- 생존율(Survival Rate): 로봇이 넘어지거나 상자를 떨어뜨리지 않고 끝까지 마친 비율
- 작업 성공률(Task Success): 끝까지 마친 회차 가운데 상자를 목표 위치 15cm 이내, 방향 오차 30도 이내로 내려놓은 비율
| 학습 단계 | 생존율 | 작업 성공률 |
|---|---|---|
| 사전학습 선생님 (레퍼런스 사용) | 96.5% | 51.9% |
| 사전학습 학생 (레퍼런스 제거) | 57.7% | 45.4% |
| 학생 + SD:DPO | 100% | 55.1% |
| 학생 + SD:DPO + DA:PPO | 99.5% | 98.8% |
시뮬레이션 Pick-Carry-Place 기준 (출처: DiPLO 논문 Table V)
레퍼런스를 함께 넣은 선생님 모델은 생존율 96.5%였지만 같은 모델에서 레퍼런스만 빼자 57.7%로 떨어졌습니다. SD:DPO는 레퍼런스 없이 움직여야 하는 학생의 생존율을 100%까지 끌어올렸습니다. 다만 작업 성공률은 55.1%에 머물렀습니다. 넘어지지 않고 상자를 들고 다니게는 됐지만 제자리에 놓는 건 아직 서툴렀다는 뜻이죠. DA:PPO까지 거치자 작업 성공률이 98.8%로 뛰었습니다. 안정적으로 움직이는 문제와 작업을 끝내는 문제를 나눠서 차례로 푼 결과입니다.
배우지 않은 목표에도 갈 수 있을까?
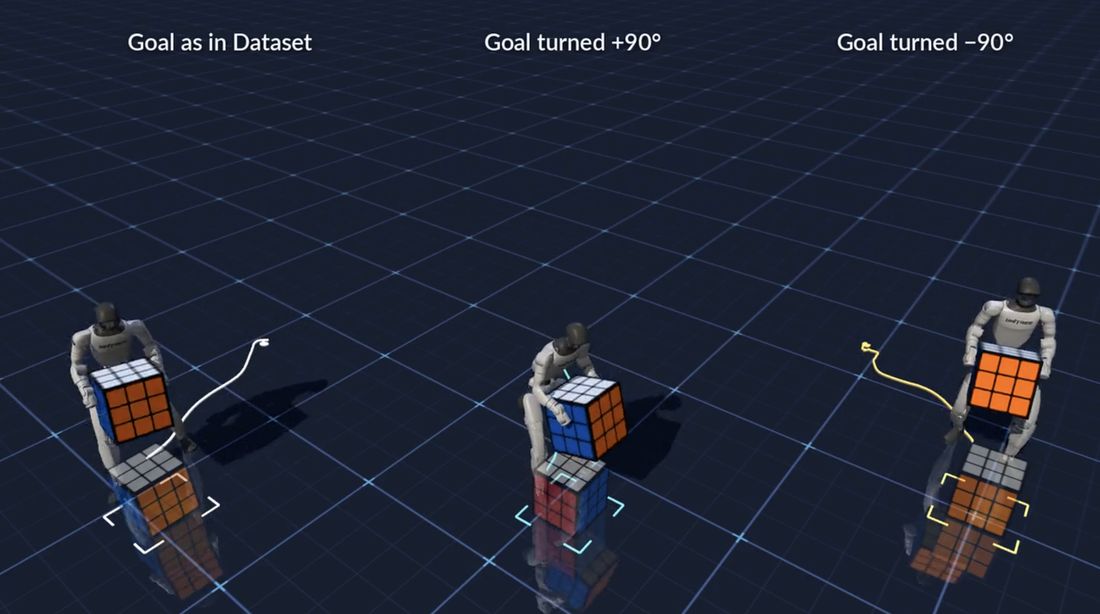
데이터셋 그대로의 목표(왼쪽)와 +90도·−90도로 돌린 목표(가운데·오른쪽)에 맞춰 서로 다른 경로를 만듭니다 (출처: DiPLO 프로젝트 페이지)
학습 데이터에서 가장 먼 목표는 출발점에서 약 1.9m였습니다. 연구진은 목표를 0.5m부터 5m까지 놓고 방향도 0도·90도·180도·270도로 바꿔 가며 시험했습니다. 결과는 생존율 약 100%에 작업 성공률 88%였습니다. 데이터에 있던 동작을 다시 재생하는 수준이 아니라 새 목표에 맞는 움직임을 새로 만든다는 걸 보여줍니다.
연구진은 상자 운반 말고도 차기(Kicking)와 밀기·당기기(Pushing/Pulling) 작업에 같은 학습 방식을 적용해 비슷한 경향을 확인했습니다. 특정 운반 작업에만 맞춘 방법이 아니라 다른 로코매니퓰레이션 작업으로도 넓힐 수 있다는 뜻입니다. 다만 이번 연구에서는 작업마다 플래너를 따로 학습했습니다. 하나의 플래너가 여러 작업을 모두 해내는 멀티태스크 학습은 아직 남은 과제입니다.
실기체에서 15번 시도해 15번 성공
마지막으로 연구진은 시뮬레이션에서 학습한 플래너와 트래커를 29자유도 유니트리 G1에 그대로 올렸습니다. 실기체에서 따로 추가 학습(Fine-tuning)은 하지 않았습니다. 앞의 98.8%는 시뮬레이션 평가 결과이고 실기체 시험은 실험실 한 곳에서 15번 진행한 제한된 검증이라는 점도 함께 기억해 두면 좋습니다.
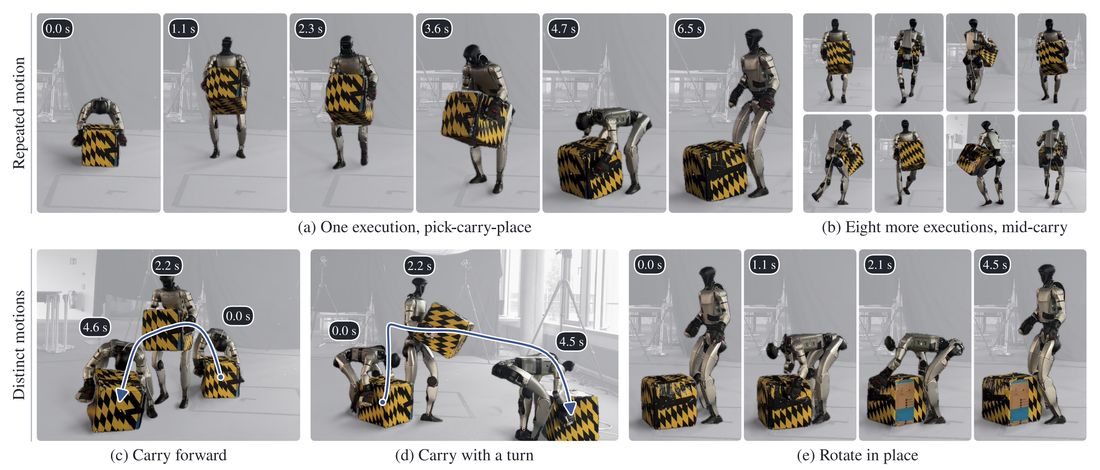
위는 같은 목표를 반복한 실행, 아래는 앞으로 운반·회전하며 운반·제자리 회전처럼 목표가 다른 실행입니다 (출처: DiPLO 논문)
| 구분 | 실기체 실행 환경 |
|---|---|
| 디퓨전 플래너 | GPU에서 별도 프로세스로 실행 (디노이징 10회) |
| RL 트래커 | CPU에서 ONNX Runtime으로 실행 |
| 로봇 상태 | 관절 엔코더와 온보드 IMU |
| 몸통·상자 위치 | 외부 모션캡처 시스템 |
| 결과 | 같은 목표 반복 10/10 · 서로 다른 목표 5/5 |
현장으로 가기 전에 남은 과제
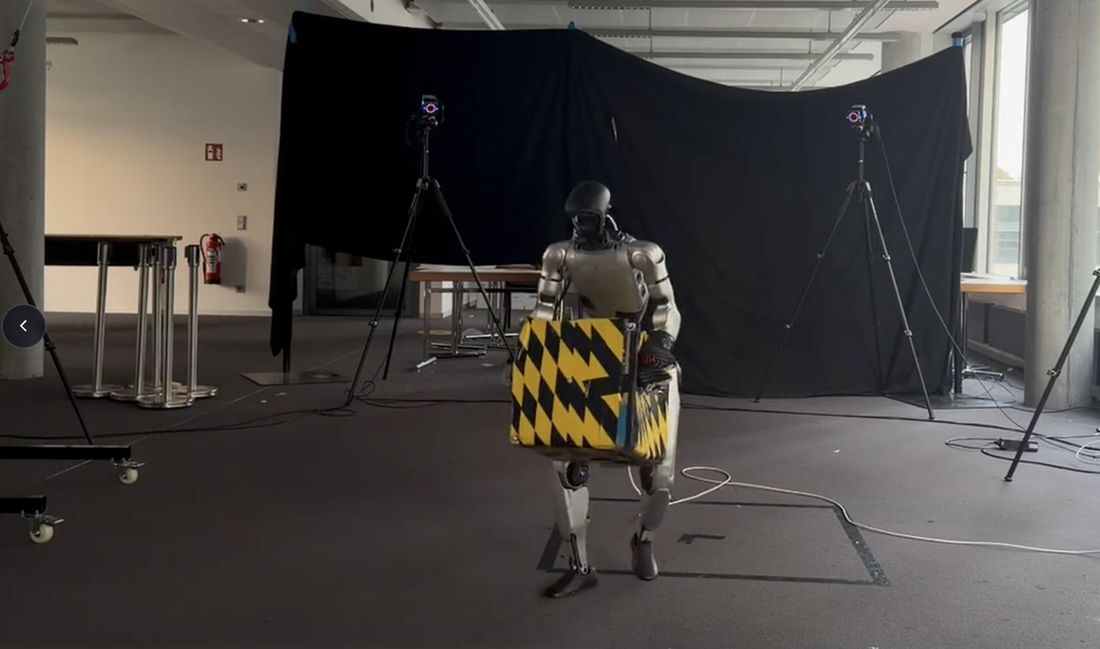
뒤편 삼각대 위 장비가 로봇과 상자의 위치를 추적한 모션캡처 카메라입니다 (출처: DiPLO 프로젝트 페이지)
결과를 읽을 때 꼭 함께 봐야 할 점이 있습니다. 실험에서 로봇 몸통과 상자의 위치는 외부 모션캡처 시스템으로 추적했습니다. 로봇이 자기 카메라로 상자를 보고 판단하는 엔드투엔드 비전 시스템은 아닙니다. "실기체에서 추가 학습 없이 실행했다"는 말도 학습한 모델을 하드웨어에 그대로 올렸다는 뜻이지 외부 센서 없이 혼자 움직였다는 뜻은 아닙니다.
산업 현장에서 쓰려면 모션캡처를 대신할 비전 기반 인식과 상태 추정이 필요하고 다양한 환경 변화에 대응하는 연구도 더 쌓여야 합니다. 그래도 시뮬레이션에서 학습한 디퓨전 플래너와 RL 트래커를 하드웨어 추가 학습 없이 실기체에 올려 작업을 해냈다는 점은 분명한 성과입니다. 휴머노이드가 자기 눈으로 물체를 보는 문제는 3편 VisualMimic 리뷰에서 다뤘습니다.
06연구실을 위한 제안
연구실에서 DiPLO를 이어가려면 무엇이 필요할까?
DiPLO에서 가져갈 것은 알고리즘 하나보다 데이터 수집부터 실기체 실행까지 이어지는 학습 구조 전체입니다. 아래 세 가지는 논문이 직접 검증한 내용이 아니라 송준봉 CTO가 연구실 관점에서 정리한 제안입니다. 휴머노이드 학습 플랫폼을 설계할 때 함께 보면 좋은 방향이에요.
1 텔레오퍼레이션 데이터를 물리적으로 늘리기
실제 로봇으로 모은 텔레오퍼레이션 데이터는 중요한 학습 자산입니다. 하지만 모은 그대로만 쓰면 다양한 초기 조건과 작업 환경에 대응하기 어렵습니다. DiPLO처럼 리타게팅한 동작을 물리 시뮬레이션에서 최적화하고 초기 조건과 물체 상태를 바꿔 실행 가능한 동작으로 늘리는 접근이 필요합니다.
2 계획과 저수준 제어를 나누기
상위 모델이 작업 목표에 맞는 전신 행동을 계획하고 하위 모델이 실제 로봇에서 안정적으로 실행하는 구조가 중요합니다. 이 구조는 다른 연구로도 넓혀 볼 수 있습니다. VLA나 RFM 같은 상위 모델이 작업의 의미를 이해하고 행동을 계획하면 하위에서는 ACT 같은 모방학습 정책이나 RL 제어기가 실제 동작 실행을 맡는 식이죠. 다만 DiPLO가 실제로 검증한 건 디퓨전 플래너와 RL 전신 트래커의 조합까지입니다. DiPLO의 플래너는 비전·언어 기반 모델이 아니어서 VLA와 같은 구조로 볼 수 없고 ACT도 RL 트래커처럼 균형을 잡는 저수준 제어기와는 역할이 다릅니다. 두 접근의 역할을 구분하면서 통합하는 것이 중요합니다.
3 시뮬레이션 후속 학습 체계 갖추기
모방학습으로 기본 동작을 확보한 다음에는 시뮬레이션에서 실제 작업 성공률을 기준으로 정책을 개선할 수 있어야 합니다. 하위 제어기를 고정하고 상위 플래너만 강화학습으로 개선하는 DiPLO의 방식은 학습 파이프라인을 설계할 때 참고할 만합니다.
🧪 이어서 연구해 볼 만한 주제
- 비전 기반 인식: 외부 모션캡처에 기대는 물체 위치·자세 추정을 온보드 카메라 인식으로 대체
- 멀티태스크 학습: 운반·차기·밀기와 당기기를 하나의 범용 플래너로 함께 학습
- 물체 다양성: 크기·무게·형태·접촉 조건이 다른 물체로 확장
- Sim-to-Real: 마찰·질량·관성·외란이 달라져도 버티는 학습 체계
- 장기 계획: 여러 작업이 이어지는 공정에서 긴 행동 계획과 실패 복구
🔗 DiPLO를 같은 기체로 재현하려면, 유니트리 G1
유니트리 G1은 DiPLO가 실기체 검증에 쓴 휴머노이드입니다. 1편 HumDex와 4편 LEGS도 G1로 실험했을 만큼 연구 현장에서 많이 쓰는 기체라 논문 결과를 같은 환경에서 재현하고 확장하기 좋습니다. 논문은 29자유도 구성을 썼으니 도입 전에 연구 목적에 맞는 자유도 구성을 함께 확인해 보세요.
유니트리 G1 자세히 보기 > 휴머노이드 전체 라인업 >
🔗 우리 과제에 맞는 사람 동작을 직접 모으려면, Moretion HZ-Z1 Pro
DiPLO는 공개 데이터셋의 동작 29개에서 출발했습니다. 연구실 과제에 맞는 동작을 직접 모으려면 사람의 전신 움직임을 정밀하게 기록할 장비가 필요합니다. Moretion HZ-Z1 Pro는 MEMS 관성 센서와 항자기 알고리즘을 쓰는 무선 전신 모션캡처 슈트로 지연 5ms 미만과 1000Hz 연산을 지원하고 최대 5명까지 동시에 캡처합니다. BVH·FBX·CSV로 내보낼 수 있어서 사람 동작 데이터를 모으는 출발점으로 쓰기 좋아요. 다만 DiPLO처럼 로봇 학습 데이터로 쓰려면 로봇 관절 구조에 맞춘 리타게팅과 물체 위치·방향 데이터 정렬 그리고 동역학을 고려한 궤적 최적화를 따로 거쳐야 합니다.
Moretion HZ-Z1 Pro 자세히 보기 >로봇과 동작 수집 장비와 데이터 환경을 하나씩 따로 알아보기 번거롭다면 마로솔 피지컬 AI 연구 패키지로 한 번에 상담받을 수 있습니다. 데이터 인프라 Data Studio는 복잡한 세팅 없이 로봇 행동 데이터를 수집할 수 있게 해 줍니다. 연구 목적과 로봇 모델에 따라 Data Studio의 연동 가능 여부와 데이터 수집 구성을 함께 확인해 드려요. Data Studio는 데이터를 모으는 인프라이고 SBTO·디퓨전·강화학습으로 이어지는 DiPLO 학습 파이프라인은 그 위에 연구실이 따로 구성하는 영역입니다. 연구 목적에 맞는 휴머노이드 라인업과 새로 더한 로봇핸드·텔레오퍼레이션 장비도 함께 살펴볼 수 있습니다.
마치며
데이터를 얼마나 모으느냐보다 어떻게 키우느냐
DiPLO는 모방학습과 디퓨전 기반 모션 생성과 강화학습을 하나의 학습 파이프라인으로 묶은 연구입니다. 처음에는 사람 동작을 적극적으로 쓰면서도 마지막 실행 단계에서는 그 레퍼런스 동작에 기대지 않게 만들었습니다. 데이터의 양만큼 그 데이터를 물리적으로 의미 있는 동작으로 키우고 실제 작업 성능으로 잇는 방법이 중요하다는 걸 보여준 셈입니다.
상위 플래너와 하위 트래커를 나누고 실행 결과를 다시 플래너 학습에 돌려주는 구조도 물체 운반을 넘어 여러 휴머노이드 작업으로 넓어질 것으로 봅니다. 피지컬 AI의 경쟁력은 모델 하나의 성능으로 정해지지 않을 겁니다. 데이터 수집과 물리 기반 데이터 생성, 모방학습과 강화학습, 시뮬레이션 검증과 실제 로봇 배포까지 이어지는 통합 학습 체계가 점점 더 중요해질 것입니다.
우리 연구실에는 어떤 구성이 맞을까요?
휴머노이드 로코매니퓰레이션 연구나 피지컬 AI 연구 환경 구축을 검토 중인 연구·교육기관이라면 목적과 예산에 맞춘 구성과 조건을 함께 제안드립니다.
📎 함께 보면 좋은 콘텐츠
- [CTO's Pick #1] 휴머노이드에게 사람의 손재주를 가르칠 수 있을까? HumDex 논문 리뷰
- [CTO's Pick #2] 휴머노이드는 왜 매번 처음부터 배워야 할까? SkillBlender 논문 리뷰
- [CTO's Pick #3] 휴머노이드는 자기 눈으로 물체를 볼 수 있을까? VisualMimic 논문 리뷰
- [CTO's Pick #4] 휴머노이드 VLA 학습 데이터, 이제 시뮬레이션으로 만든다. 스탠퍼드 LEGS 논문 분석
- [CTO's Pick #5] 모방학습 로봇은 사람 시연보다 빨라질 수 없을까? RACE 논문 리뷰
- [CTO's Pick #6] 덱스터러스 핸드는 왜 드릴을 못 잡을까? 손가락별 어포던스로 로봇 손 파지를 푼 FSAG 논문 리뷰
- [CTO's Pick #7] VLA는 모든 걸 혼자 다 해야 할까? 계층형 VLA를 제안한 HAMSTER 논문 리뷰
출처
Omar, S., Sanokowski, S., Daneshmand, E., Yu, D., Cremers, D., Schmid, C., Khadiv, M. (2026). DiPLO: Self-distilled Diffusion Planning for Loco-manipulation. arXiv:2610.24847
프로젝트 페이지 : atarilab.github.io/diplo-website
본문 이미지 : DiPLO 논문 및 프로젝트 페이지


