VLA는 모든 걸 혼자 다 해야 할까? 계층형 VLA를 제안한 HAMSTER 논문 리뷰
1분0180
VLA에게 로봇 관절 하나하나까지 다 맡겨야 할까요?
요즘 VLA 모델(Vision-Language-Action)은 이미지와 자연어 명령만으로 로봇 action까지 바로 출력하는 쪽으로 발전하고 있습니다. 계층형 VLA는 이 방식이 실제 로봇 데이터를 너무 많이 필요로 한다는 문제를 역할 분담으로 풉니다. 상황을 이해하는 일은 VLM에게 맡기고 정밀한 3D 제어는 별도의 정책에게 맡기는 식입니다. 시뮬레이션과 다른 로봇의 데이터로 VLM을 학습시켜 일반화 성공률을 OpenVLA의 약 2배까지 끌어올린 논문 HAMSTER를 빅웨이브로보틱스 송준봉 CTO가 해설합니다.
CTO'S PICK · 07
송준봉 | 빅웨이브로보틱스 CTO
빅웨이브로보틱스의 기술 총괄. 매달 주목할 만한 휴머노이드·피지컬 AI 논문을 한 편씩 골라 연구자와 실무자의 눈높이에서 해설합니다.
01들어가며
VLA 모델은 왜 그렇게 많은 로봇 데이터가 필요할까?
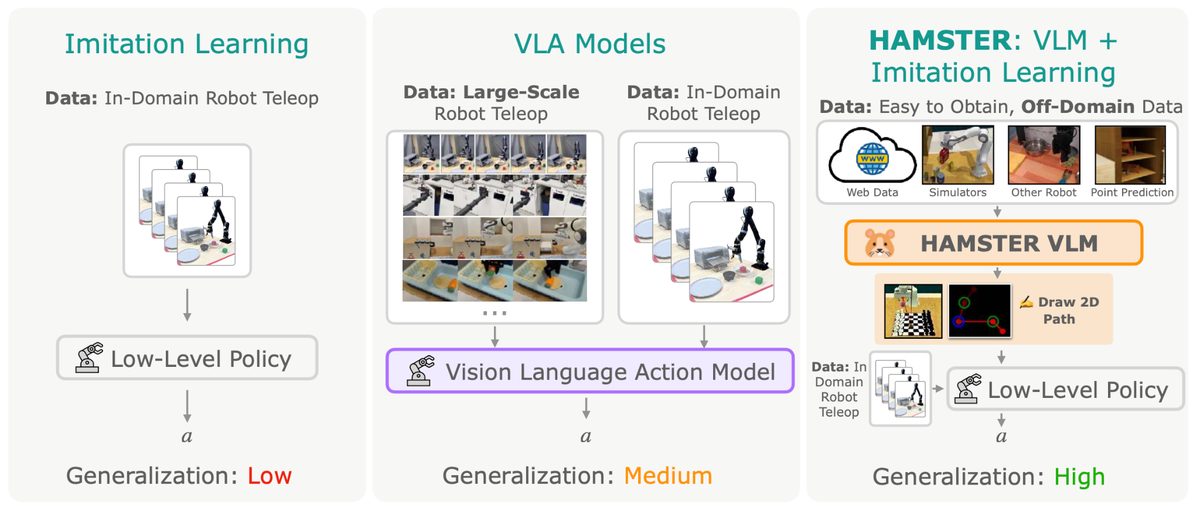
왼쪽부터 모방학습 정책 단독과 대규모 로봇 데이터로 학습한 VLA 그리고 HAMSTER입니다. HAMSTER는 웹 데이터나 시뮬레이션처럼 구하기 쉬운 데이터로 VLM을 학습시키고 실제 로봇 데이터는 하위 정책에만 씁니다. (출처: HAMSTER 논문 Figure 1)
최근 VLA(Vision-Language-Action) 모델은 카메라 이미지와 "컵을 집어서 테이블 위에 놓아라" 같은 자연어 명령을 이해하고 로봇의 action까지 곧바로 출력하는 방향으로 발전하고 있습니다. 문제는 데이터입니다. VLA 하나가 환경 이해부터 정밀한 3D 제어까지 모두 맡으려면 로봇 데이터가 많이 필요한데 실제 로봇으로 데이터를 모으는 비용이 만만치 않습니다.
관절 움직임이나 그리퍼 제어 같은 action 데이터는 실제 로봇을 움직여야만 얻을 수 있습니다. 웹 동영상이나 사람 손동작 영상 또는 시뮬레이션 데이터는 훨씬 구하기 쉽습니다. 다만 여기에는 특정 로봇의 정확한 action 정보가 빠져 있는 경우가 대부분입니다. 꼭 필요한 데이터는 비싸고 흔한 데이터는 바로 쓰기 어려운 상황입니다.
지금까지 로봇 학습은 이 문제 앞에서 크게 두 갈래로 나뉘었습니다. HAMSTER가 제안하는 방식까지 나란히 놓고 보면 차이가 잘 보입니다.
| 접근 방식 | 필요한 데이터 | 특징 |
|---|---|---|
| 모방학습 정책 단독 RVT-2 / 3D Diffuser Actor / ACT | 소량의 실제 로봇 텔레오퍼레이션 데이터 | 적은 데이터로도 정밀한 3D 제어가 되지만 환경이나 지시어가 바뀌면 쉽게 무너짐 |
| 모놀리식 VLA RT-2 / OpenVLA | 대규모 실제 로봇 데이터 | 의미 이해와 일반화는 낫지만 데이터 비용이 크고 매 스텝 VLM을 호출해서 제어 주기가 느림 |
| 계층형 VLA HAMSTER | 오프도메인 데이터와 소량의 실제 로봇 데이터 | VLM은 경로만 그리고 하위 정책은 정밀 제어만 맡아 두 방식의 장점을 합침 |
이번에 소개할 HAMSTER: Hierarchical Action Models For Open-World Robot Manipulation은 NVIDIA와 워싱턴대학교 그리고 서던캘리포니아대학교 연구진이 발표한 논문으로 ICLR 2025에 채택됐습니다. 공개된 지 1년 반이 넘은 논문을 지금 고른 데는 이유가 있습니다. 그동안 고수준 추론과 저수준 제어를 나누는 계층 구조가 VLA 설계에서 점점 많이 쓰이고 있기 때문입니다. 올해 6월에는 HAMSTER의 2D 경로에 깊이 정보를 더해 3D 궤적으로 확장한 후속 연구 3D HAMSTER도 나왔습니다. 계층형 VLA를 제대로 이해하려면 그 출발점인 이 논문부터 보는 게 가장 빠릅니다.
02HAMSTER 핵심 구조
계층형 VLA는 어떻게 작동할까? VLM은 경로를 / 3D 정책은 동작을
HAMSTER는 이 문제에 대해 "VLM이 로봇의 모든 관절 하나하나의 action까지 다 예측해야 할까?"라고 묻습니다. 그리고 상위 제어와 하위 제어를 나눈 계층 구조를 대안으로 내놓습니다. VLM은 어떤 행동을 해야 하는지만 판단하고 관절의 정밀한 제어는 별도의 3D manipulation policy가 맡는 방식입니다. 이렇게 나누면 VLM은 복잡한 관절 제어를 배울 필요가 없습니다. 하위 정책도 무엇을 해야 하는지 같은 의미 이해까지 떠안지 않아도 됩니다.
기존 VLA 모델은 이미지와 언어를 받아 로봇이 수행할 action을 직접 예측합니다. 그런데 action은 로봇마다 다릅니다. 관절 구조나 그리퍼 형태 또는 제어 방식이 바뀌면 action도 달라집니다. 그래서 한 로봇에서 배운 action을 다른 로봇이나 다른 환경으로 옮기기가 쉽지 않습니다.
HAMSTER의 VLM은 최종 action을 만들지 않습니다. 이미지와 언어 명령을 이해한 뒤 로봇의 엔드이펙터(end-effector)가 이미지 안에서 어떤 길로 움직여야 하는지를 2D 경로(2D Path)로 그려냅니다. 수식으로 쓰면 다음과 같습니다.
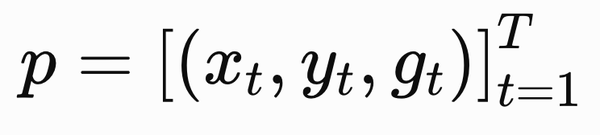
xt와 yt는 시간 t에 엔드이펙터가 이미지 안에서 있어야 할 위치이고 gt는 그 순간의 그리퍼 상태입니다. 그리퍼가 열렸는지 닫혔는지를 나타내는 값이죠. 좌표는 이미지 크기를 기준으로 0에서 1 사이 값으로 바꿔 씁니다. 결국 이 수식은 목표 지점 하나를 가리키는 게 아닙니다. 엔드이펙터가 시간에 따라 어디로 움직이고 그리퍼를 언제 여닫는지를 경로 하나에 담은 것입니다.
VLM이 실제로 내놓는 결과물은 텍스트로 된 좌표 목록입니다. 논문은 학습에 쓴 경로를 Ramer-Douglas-Peucker 알고리즘으로 단순화해서 짧은 작업 기준으로 점을 2~5개만 남겼습니다. 세밀한 움직임은 하위 정책에 넘기고 VLM은 큰 흐름만 보게 하려는 설계입니다.
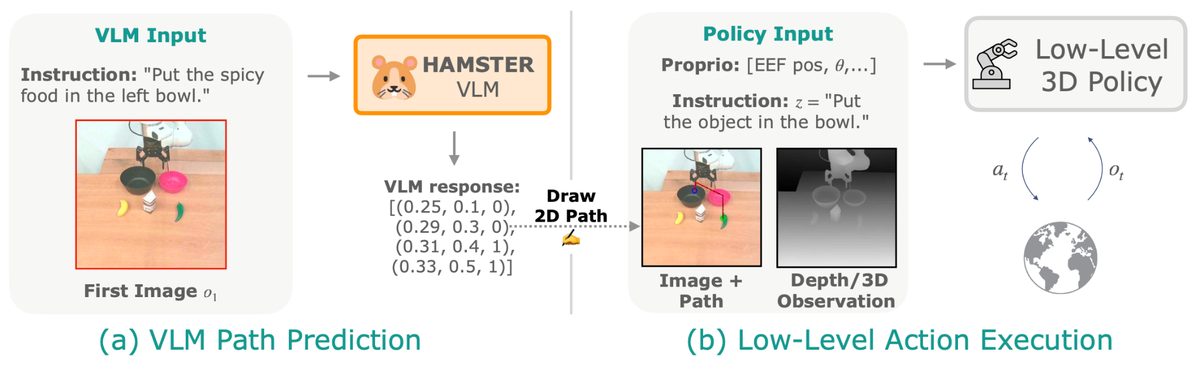
(a) VLM은 첫 이미지와 명령을 보고 2D Path를 생성합니다. (b) 하위 3D 정책은 경로가 그려진 이미지와 depth 그리고 로봇 상태를 받아 매 스텝 action을 만듭니다. (출처: HAMSTER 논문 Figure 2)
위 그림의 "Put the spicy food in the left bowl"이라는 명령을 예로 들어보겠습니다. HAMSTER의 VLM은 관절각이나 Cartesian velocity를 출력하지 않습니다. 엔드이펙터가 매운 음식 쪽으로 가서 물체를 잡고 왼쪽 그릇으로 옮기는 과정을 2D Path로 그릴 뿐입니다. 여러 물체 가운데 어떤 게 "매운 음식"인지 알아보는 것도 VLM이 할 일입니다. 여기서 기억할 점은 2D Path가 최종 로봇 action이 아니라는 것입니다.
생성된 2D Path는 현재 이미지 위에 그대로 그려진 채 하위 3D 정책으로 넘어갑니다. 시간 순서는 색의 그라데이션으로 나타내고 그리퍼를 여닫는 지점은 작은 원으로 표시합니다. 하위 정책은 이 경로를 그냥 따라가지 않습니다. depth/3D observation과 robot proprioception(관절과 엔드이펙터의 현재 상태)을 함께 봅니다. 그래서 이미지에서는 같은 자리에 보이는 물체라도 실제 깊이와 로봇의 현재 자세를 따져서 필요한 3차원 움직임을 만들어냅니다. 논문에서는 포인트클라우드를 입력받는 RVT-2와 3D Diffuser Actor(3D-DA)를 하위 정책으로 썼습니다.
"모델 하나가 모든 문제를 해결하려 하지 않고 계층을 나눕니다. VLM은 무엇을 해야 하는지와 손이 어느 방향으로 가야 하는지를 이해하고 하위 3D 정책은 그 경로를 실제 로봇이 어떻게 움직여 수행할지를 결정합니다."
내비게이션과 운전자를 떠올리면 이해가 쉽습니다. 내비게이션은 지도에 경로선을 그려주지만 핸들을 대신 잡지는 않습니다. 실제 도로에서 거리를 가늠하고 차선을 맞추는 건 운전자의 일입니다. HAMSTER에서 2D Path는 두 모델을 잇는 중간 표현(intermediate representation)입니다. 이미지 위의 경로는 joint action과 달리 특정 로봇의 관절 구조에 덜 묶여 있습니다. 덕분에 서로 다른 로봇의 데이터나 시뮬레이션 데이터에서도 같은 형태로 뽑아 쓸 수 있습니다.
속도에서도 이득이 있습니다. 모놀리식 VLA는 action을 낼 때마다 VLM을 호출합니다. 70억 파라미터 규모의 OpenVLA는 RTX 4090에서도 초당 6번 정도밖에 명령을 내지 못합니다. HAMSTER는 한 에피소드에서 VLM을 한 번이나 몇 번만 부르고 나머지는 가벼운 하위 정책이 처리합니다. VLM을 더 큰 모델로 바꿔도 실행 속도가 크게 느려지지 않는 이유입니다. VLA의 추론 지연 문제는 5편 RACE 리뷰에서 다른 방향으로 다룬 적이 있습니다(👉 5편 콘텐츠 확인하기).
HAMSTER가 VLM의 역할을 줄인 건 아닙니다. VLM이 잘하는 시각·언어 이해와 하위 정책이 잘하는 정밀한 3D 제어를 떼어놓고 그 사이를 2D Path로 이었습니다. 이 연구에서 가장 중요한 지점이 바로 여기입니다.
03오프도메인 데이터 학습
실제 로봇 데이터 없이도 VLM을 학습할 수 있을까? 오프도메인 데이터의 힘
HAMSTER가 2D Path를 쓰는 이유는 VLM의 출력을 단순하게 만드는 데서 끝나지 않습니다. 더 큰 목적은 실제 로봇에서는 모으기 힘든 다양한 데이터를 VLM 학습에 끌어오는 것입니다.
보통 로봇을 학습시키려면 카메라 이미지와 함께 실제 로봇 관절의 action 데이터가 필요합니다. 텔레오퍼레이션으로 로봇을 움직이며 데이터를 모으는 일은 시간도 비용도 많이 듭니다. 로봇 종류가 바뀌면 관절 구조와 action space도 함께 바뀝니다. 사람이 물건을 다루는 영상이나 다른 로봇의 데이터 또는 시뮬레이션 데이터에서는 정확한 로봇 action을 얻기 어렵습니다. 하지만 손이나 엔드이펙터가 이미지에서 어느 쪽으로 움직였는지는 뽑아낼 수 있습니다. 논문은 이렇게 실제 배치 환경 밖에서 얻은 데이터를 오프도메인 데이터(off-domain data)라고 부릅니다.
HAMSTER는 이런 데이터를 모두 2D Path라는 같은 형식으로 바꿔 VLM 학습에 썼습니다. 베이스 모델은 130억 파라미터 규모의 VILA-1.5-13B이고 학습 데이터는 아래처럼 구성했습니다.
📊 HAMSTER VLM 학습에 쓰인 오프도메인 데이터 (논문 4.1절)
- RoboPoint 포인트 예측 데이터 약 77만 건 (이미지에서 물체 위치와 놓을 자리 찾기)
- RLBench 시뮬레이션 경로 약 32만 건 (81개 작업마다 1,000 에피소드)
- Bridge와 DROID의 실제 로봇 경로 약 11만 건 (실험과 다른 로봇과 다른 환경)
- 일반 VQA 데이터 약 66만 건 (VLM이 가진 상식을 잃지 않도록 함께 학습)
이 중에 실험 환경에서 모은 데이터는 하나도 없습니다. 하위 정책에 쓴 실제 로봇 데이터는 Franka Panda 팔을 텔레오퍼레이션해서 모은 320 에피소드가 전부입니다. 집어 옮기기 220개와 쓰러뜨리기 50개 그리고 버튼 누르기 50개입니다.
Bridge와 DROID를 다룬 방식도 살펴볼 만합니다. 두 데이터셋에는 로봇 action 정보가 들어 있습니다. 그런데 HAMSTER는 이걸 action으로 쓰지 않았습니다. 엔드이펙터가 화면 속에서 어떻게 움직였는지만 뽑아서 영상처럼 썼습니다. 논문은 같은 원리로 point tracking 기술을 쓰면 action 라벨이 없는 일반 영상에서도 경로를 뽑을 수 있다고 설명합니다. 시뮬레이션 데이터로 VLA를 학습시키는 다른 접근은 4편 LEGS 리뷰에서 다뤘습니다. 함께 읽으면 두 방식의 차이가 잘 드러납니다(👉 4편 콘텐츠 확인하기).
그렇다면 시뮬레이션이나 다른 환경에서 배운 2D Path가 실제 로봇 환경에서도 통했을까요? HAMSTER는 실제 환경 이미지와 언어 명령을 주고 VLM이 그린 2D Path를 비교했습니다. 아래 그림에서 HAMSTER w/o Sim Data는 시뮬레이션 데이터 없이 학습한 모델입니다. HAMSTER는 RLBench 시뮬레이션 데이터까지 넣어 학습한 모델이고 오른쪽 두 열은 파인튜닝 없이 GPT-4o로 경로를 만든 기존 방식(RT-Trajectory)입니다.
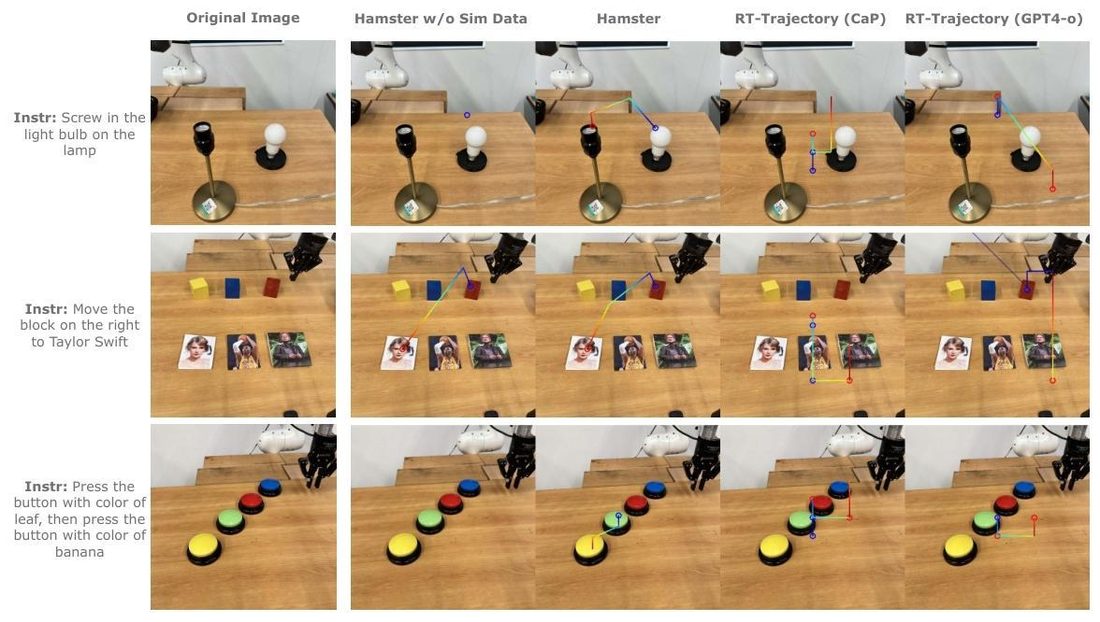
같은 장면과 명령에 대해 모델마다 그린 경로입니다. 파란색에서 빨간색으로 갈수록 시간이 흐른 것이고 원은 그리퍼를 닫고 여는 지점입니다. (출처: HAMSTER 논문 Figure 13)
그림에는 전구를 램프에 끼우는 작업과 블록을 지정한 사진 위로 옮기는 작업이 있습니다. "잎사귀 색 버튼을 누른 다음 바나나 색 버튼을 눌러라"처럼 순서가 있는 작업도 들어 있습니다. HAMSTER는 목표 물체의 위치만 찾는 데서 그치지 않고 로봇이 어떤 순서로 움직여야 하는지까지 2D Path에 담아냈습니다. 로봇 학습 연구자 5명이 48개 장면을 보고 각 모델의 경로에 순위를 매긴 결과도 마찬가지였습니다.
📊 경로 품질 인간 평가 (논문 Table 5, 평균 순위는 낮을수록 좋음)
- GPT-4o로 경로 직접 생성 (RT-Trajectory) 평균 3.47위
- GPT-4o와 Code-as-Policies 조합 (RT-Trajectory) 평균 3.41위
- HAMSTER에서 시뮬레이션 데이터만 뺀 모델 평균 2.13위
- 오프도메인 데이터를 모두 쓴 HAMSTER 평균 1.40위
거대한 범용 모델에 그대로 맡기는 것보다 구하기 쉬운 데이터로 파인튜닝한 오픈소스 VLM이 더 나은 경로를 그렸습니다. 실제 환경과 전혀 다르게 생긴 시뮬레이션 데이터를 더했을 뿐인데 순위가 꽤 올라간 점도 눈에 띕니다.
이 실험에서 놓치지 말아야 할 부분이 있습니다. 시뮬레이션 로봇의 관절 궤적을 실제 로봇에 그대로 가져다 쓰는 게 아닙니다. HAMSTER가 배우는 건 그 궤적을 이미지 평면에 옮긴 2D End-Effector Path입니다. 그래서 시뮬레이션 속 로봇과 실제 로봇의 생김새가 달라도 "지금 이 장면에서 손이 어디서 어디로 가야 하는가"라는 작업의 공간 구조는 공유할 수 있습니다.
거꾸로 보면 HAMSTER 구조에서 실제 로봇 데이터가 꼭 필요한 곳은 하위 정책 하나입니다. 논문도 협동로봇 팔 한 대로 320 에피소드를 모아 하위 정책을 학습시켰습니다.
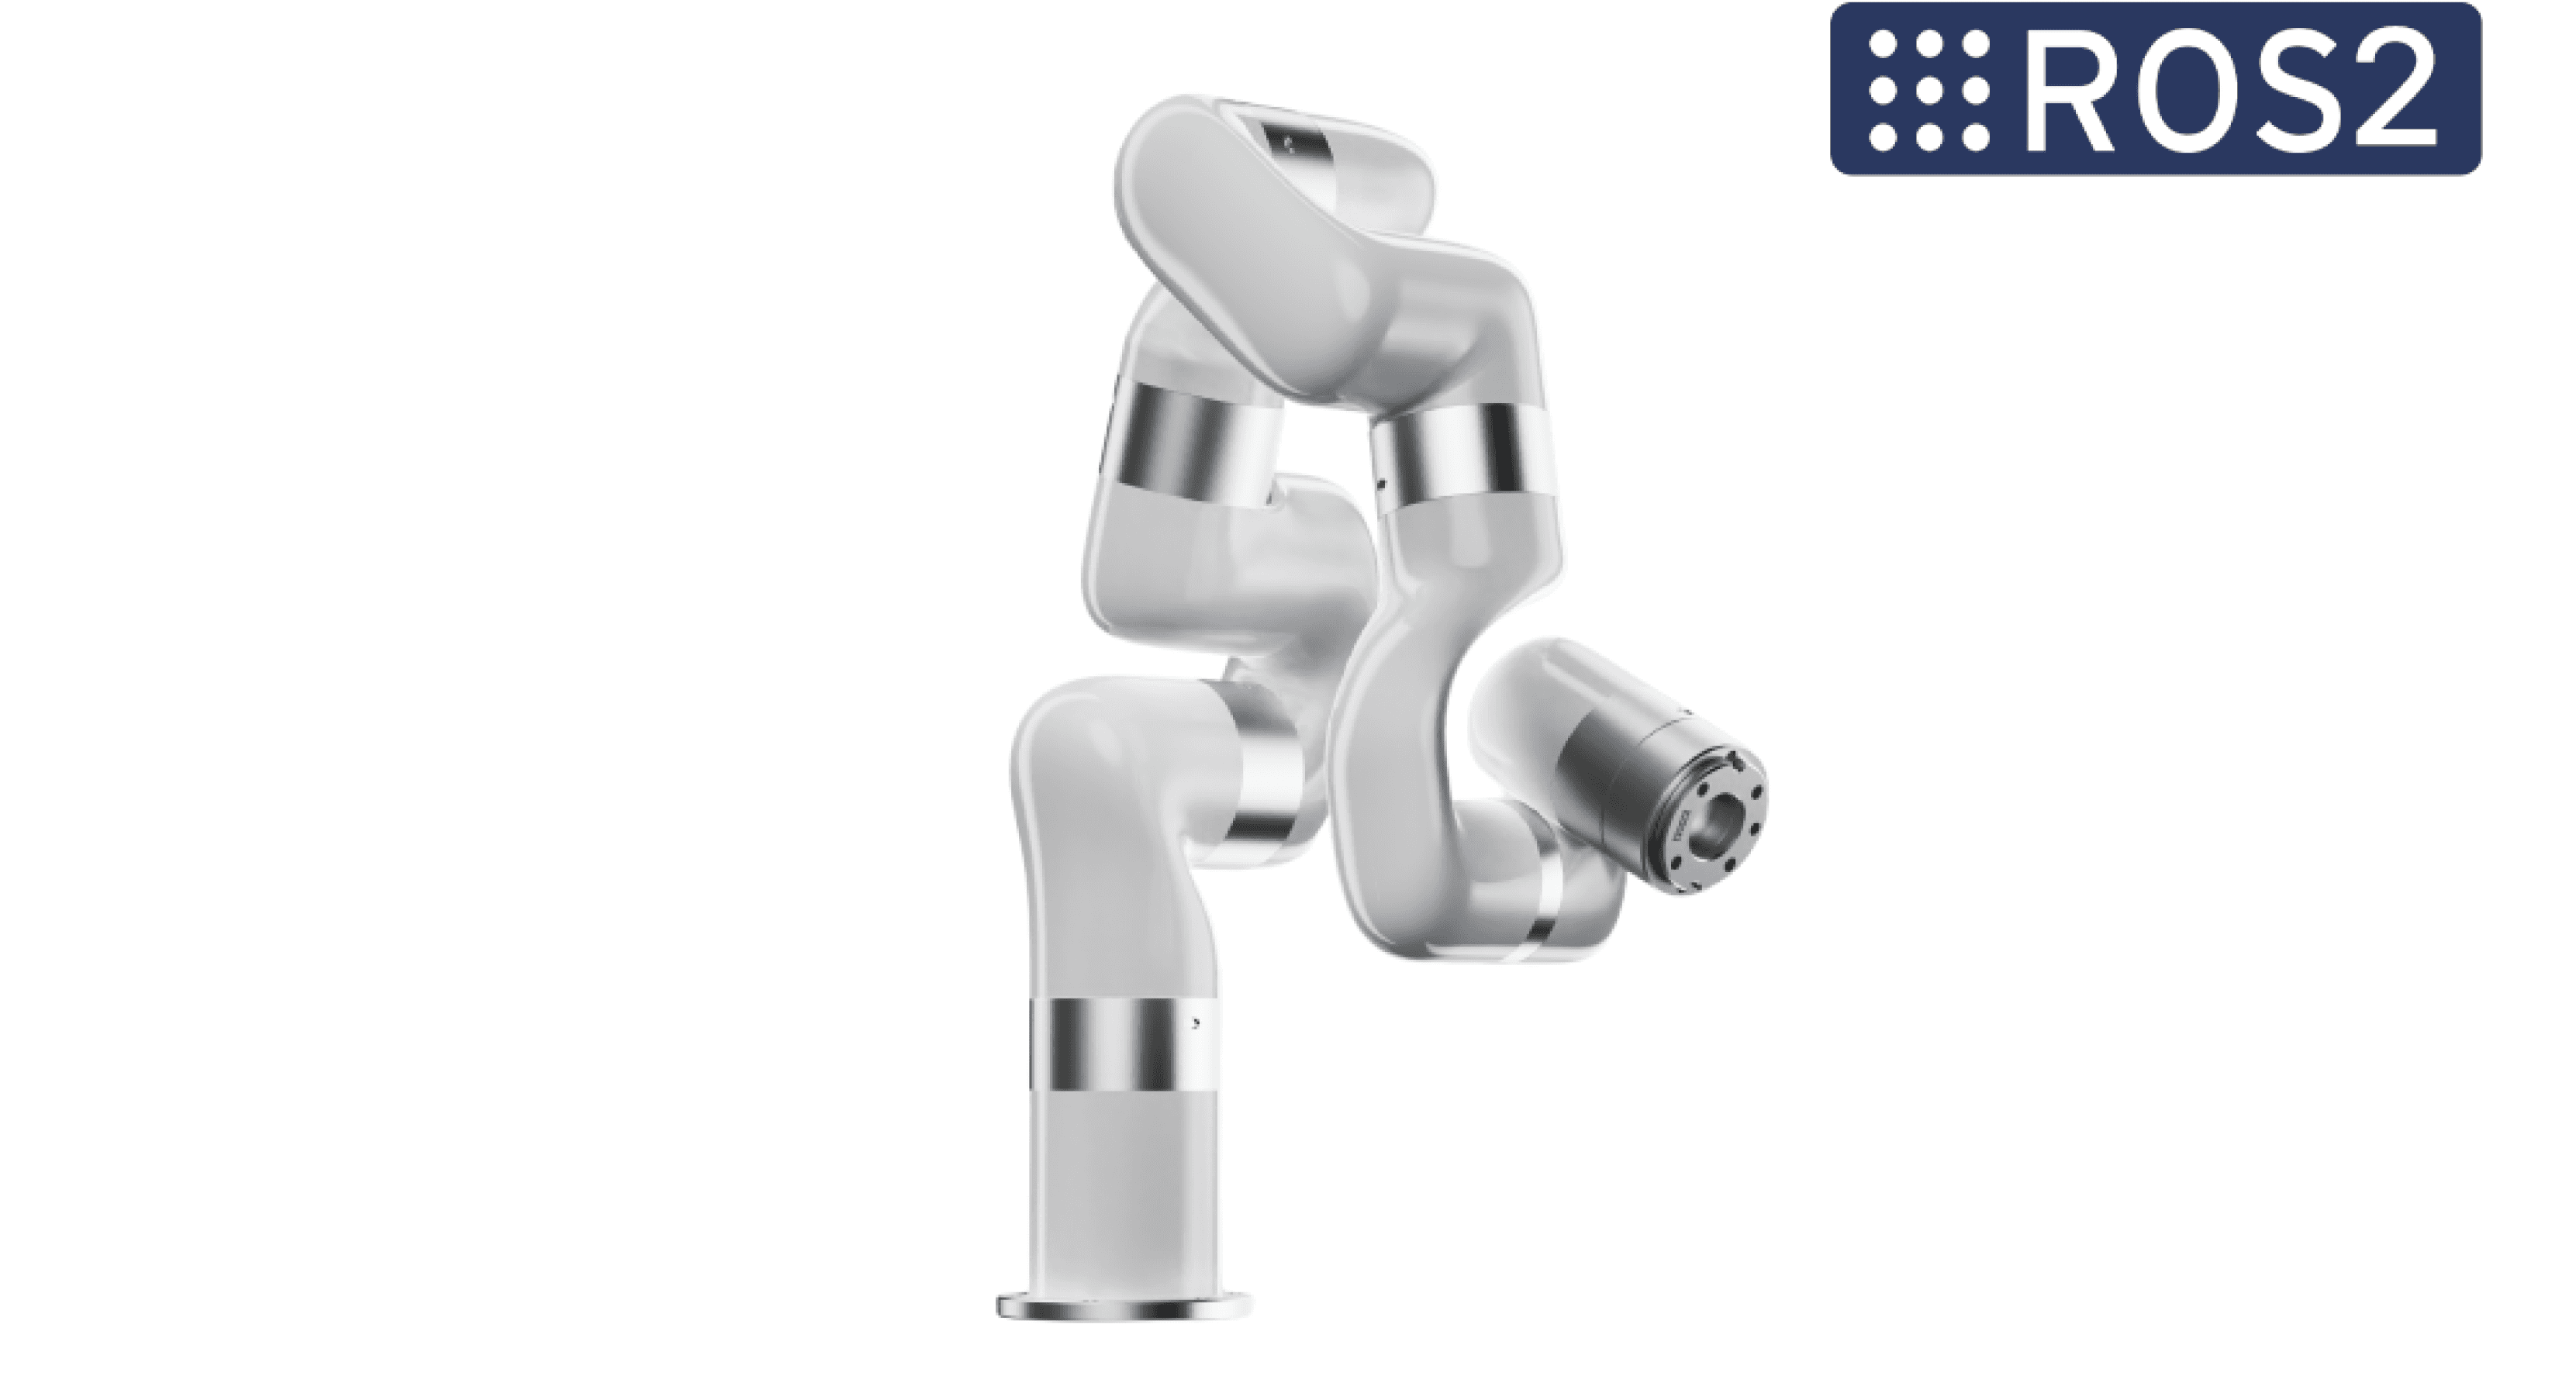
🔗 하위 정책을 가르칠 연구용 협동로봇 UFACTORY xArm
UFACTORY xArm은 5축과 6축 그리고 7축 모델로 나뉘는 연구용 협동로봇 라인업입니다. Python과 C++ SDK에 ROS까지 지원해서 RVT-2나 3D Diffuser Actor 같은 오픈소스 정책을 실제 팔에 올려 검증하기 좋습니다. 논문의 Franka Panda처럼 7자유도로 자세에 여유를 두고 싶다면 xArm7이 맞습니다. 테이블 위에서 집어 옮기는 실험이 중심이라면 xArm5나 xArm6로 시작해도 충분합니다.
xArm7 자세히 보기 > xArm 시리즈 전체 보기 >04실험 결과
7가지 일반화 실험, HAMSTER는 얼마나 달랐을까?
실제 로봇 실험에서도 결과는 같았습니다. 논문은 실제 환경에서 7가지 일반화(generalization) 조건을 만들었습니다. Basic / Object & Goal / Visual / Language / Spatial / Novel Object / Multiple입니다. 학습한 작업을 반복하는 수준이 아닙니다. 물체와 목표의 조합이 바뀌는 경우와 테이블 질감이나 조명 또는 주변 물건이 달라지는 경우까지 시험했습니다. "사탕" 대신 "단 물건"처럼 처음 듣는 지시나 처음 보는 물체가 나오는 경우도 들어갔습니다. 작업은 집어 옮기기 외에 버튼 누르기와 물체 쓰러뜨리기처럼 잡지 않고 다루는 작업도 포함했고 모두 74개 작업에서 222번 평가했습니다.
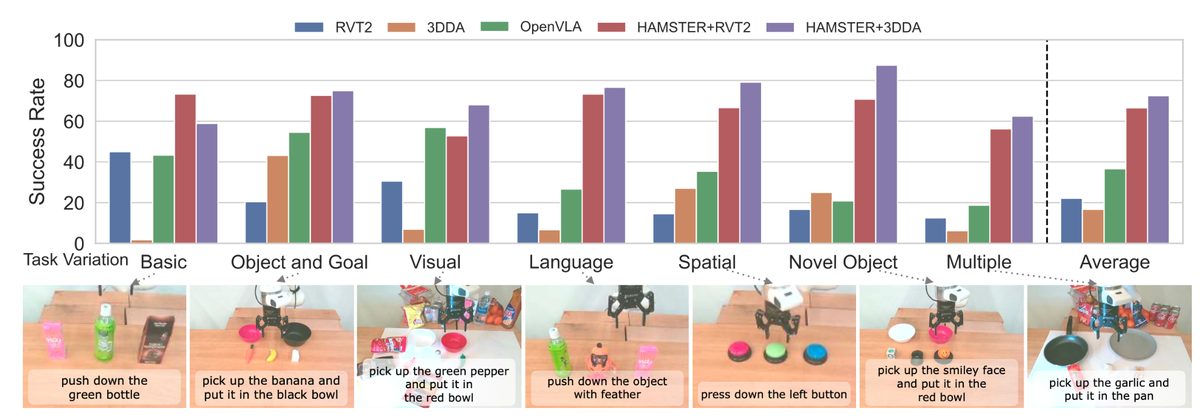
일반화 조건별 성공률입니다. 같은 하위 정책(RVT2와 3D-DA)에 HAMSTER의 VLM을 붙이면 단독으로 쓸 때보다 모든 조건에서 성공률이 오릅니다. (출처: HAMSTER 논문 Figure 4)
📊 7가지 일반화 조건 평균 성공률 (논문 Figure 4)
- RVT2 단독 22.1% / HAMSTER + RVT2 66.6%
- 3D-DA 단독 16.7% / HAMSTER + 3D-DA 72.6%
- 같은 실제 로봇 데이터로 파인튜닝한 OpenVLA 36.1%
OpenVLA는 그대로는 일반화가 잘 되지 않아서 공정하게 비교하려고 하위 정책과 같은 텔레오퍼레이션 데이터로 파인튜닝한 뒤 평가했습니다.
RVT2와 3D-DA를 단독으로 썼을 때 평균 성공률은 각각 22.1%와 16.7%였습니다. OpenVLA는 36.1%였습니다. 여기에 HAMSTER의 계층 구조를 더하자 RVT2는 66.6%로 3D-DA는 72.6%로 올라갔습니다. 하위 정책은 그대로 두고 상위 VLM과 2D Path만 붙였는데 성공률이 세 배 넘게 뛰었습니다. 대표적인 모놀리식 VLA인 OpenVLA와 비교해도 두 배 가까운 차이입니다.
RVT2를 쓰든 3D-DA를 쓰든 결과가 똑같이 좋아졌다는 점도 중요합니다. HAMSTER가 특정 하위 정책에 기대는 구조가 아니라는 얘기니까요.
"성능이 오른 건 새로운 하위 정책을 써서가 아닙니다. 상위 VLM이 작업을 이해해 2D Path를 만들고 하위 정책이 그 경로를 실제 3D 움직임으로 바꾸는 계층 구조 덕분입니다."
이 주장을 뒷받침하는 실험이 하나 더 있습니다. 저자들은 HAMSTER가 앞선 이유가 RLBench 데이터를 더 쓴 덕분은 아닌지 확인하려고 OpenVLA에도 같은 RLBench 데이터를 학습시켰습니다. 결과는 오히려 조금 떨어졌습니다. 성공 점수가 0.58에서 0.54가 됐습니다. 시뮬레이션과 실제 환경은 action 체계도 관측 방식도 다릅니다. action을 직접 출력하는 구조에서는 같은 데이터가 도움이 되지 않았던 겁니다. 데이터를 제대로 쓰려면 구조부터 나눠야 한다는 걸 보여주는 결과입니다.
데이터 효율도 좋았습니다. 시각적 변화가 많은 Colosseum 시뮬레이션 벤치마크 5개 작업에서 HAMSTER + 3D-DA는 시연 데이터를 절반만 쓰고도 성공 점수 0.36을 냈습니다. 데이터를 다 쓴 3D-DA 단독(0.18)의 두 배입니다. 카메라 위치를 학습 때와 다르게 옮긴 실험에서는 OpenVLA가 0.60에서 0.23으로 떨어졌습니다. 경로를 별도 이미지 채널로 넣은 HAMSTER + RVT2는 0.98을 유지했습니다.
HAMSTER는 오프도메인 데이터와 시뮬레이션 데이터로 VLM에게 2D Path 그리는 법을 가르칩니다. 실제 로봇에서는 그 경로를 받은 하위 정책이 depth와 3D geometry 그리고 로봇 상태 정보를 활용해 정밀하게 움직입니다. 모든 데이터를 로봇 action으로 바꿔 VLA 하나가 직접 제어하게 하는 방식과는 출발점이 다릅니다. 여러 데이터에서 공통으로 얻을 수 있는 2D Path를 먼저 배우고 정밀한 제어는 따로 맡깁니다. 위 실험들은 이렇게 데이터와 제어를 나눴을 때 실제 환경의 다양한 변화에 더 잘 버틴다는 걸 보여줍니다.
05한계와 확장
HAMSTER의 한계와 연구자를 위한 확장 아이디어
HAMSTER에도 한계는 있습니다. 논문이 직접 밝힌 내용은 세 가지입니다.
- 2D 좌표만 예측합니다. VLM이 이미지 평면의 점만 내놓기 때문에 실제 3D 공간을 이해하지는 못합니다. 경로의 한 점이 물체 위를 가리키는지 뒤를 가리키는지 헷갈리는 깊이 모호성이 실패 원인 중 하나였습니다.
- 경로에 담기지 않는 정보가 있습니다. 2D Path로 전달할 수 있는 정보는 많지 않습니다. 힘을 얼마나 줄지나 손목을 얼마나 돌릴지 같은 정보는 담지 못합니다.
- 한 번 그린 경로는 고치지 못합니다. 경로는 작업을 시작할 때 한 번 만듭니다. 실행 중에 환경이 크게 바뀌어도 경로를 다시 그리지 않습니다.
실패 분석 결과도 참고할 만합니다. RVT2 기반에서는 실패의 72%가 하위 정책이 경로를 제대로 따라가지 못해서 생겼습니다. 3D-DA 기반에서는 실패의 90%가 마지막 실행 단계에서 나왔습니다. 경로는 잘 따라갔는데 잡는 각도가 틀려 물체가 미끄러지는 식입니다. 경로를 잘 그리는 일과 손끝에서 잘 해내는 일은 따로 풀어야 하는 문제입니다.
첫 번째 한계는 벌써 후속 연구로 이어졌습니다. 올해 6월 공개된 3D HAMSTER는 상위 VLM이 이미지 좌표에 실제 깊이 값까지 더한 3D 엔드이펙터 궤적을 예측하도록 바꿨습니다. 상위 모델의 출력이 하위 3D 정책이 움직이는 공간과 바로 맞아떨어지게 만든 것입니다. 아래 CTO 제안에 있는 "3D Waypoint나 3D Pointmap을 중간 표현으로 쓰는 방법"과 같은 방향입니다.
"2D Path를 공통 중간 표현으로 두고 오프도메인 데이터와 적은 양의 실제 로봇 데이터를 조합하는 방식은 여러 하위 정책과 휴머노이드로까지 넓혀볼 수 있습니다."
송준봉 빅웨이브로보틱스 CTO
- 2D Path를 Robot Learning의 공통 Intermediate Representation으로 활용
VLM과 ACT나 Diffusion Policy 또는 3D Policy 같은 여러 low-level policy를 2D Path로 연결하는 구조를 연구할 수 있습니다. - Off-domain Data와 소량의 실제 Robot Data 조합
시뮬레이션과 사람 영상 그리고 다른 로봇 데이터로 high-level model을 먼저 학습합니다. 실제 로봇 데이터는 low-level control에 집중해서 씁니다. - 휴머노이드에서는 2D Path를 Upper-body Task Representation으로 활용
물체를 잡고 옮기고 놓는 semantic planning은 VLM이 맡고 실제 관절 제어는 별도의 manipulation policy가 맡는 구조를 적용할 수 있습니다.
두 번째 제안대로 실제 로봇 데이터를 줄이면 하위 정책이 배우는 데이터 한 건 한 건이 더 정확해야 합니다. 앞에서 본 것처럼 3D-DA 기반 실패도 대부분 마지막 실행 단계에서 나왔습니다. 사람의 손재주를 로봇 시연 데이터로 옮기는 방법은 1편 HumDex 리뷰에서 자세히 다뤘습니다(👉 1편 콘텐츠 확인하기).
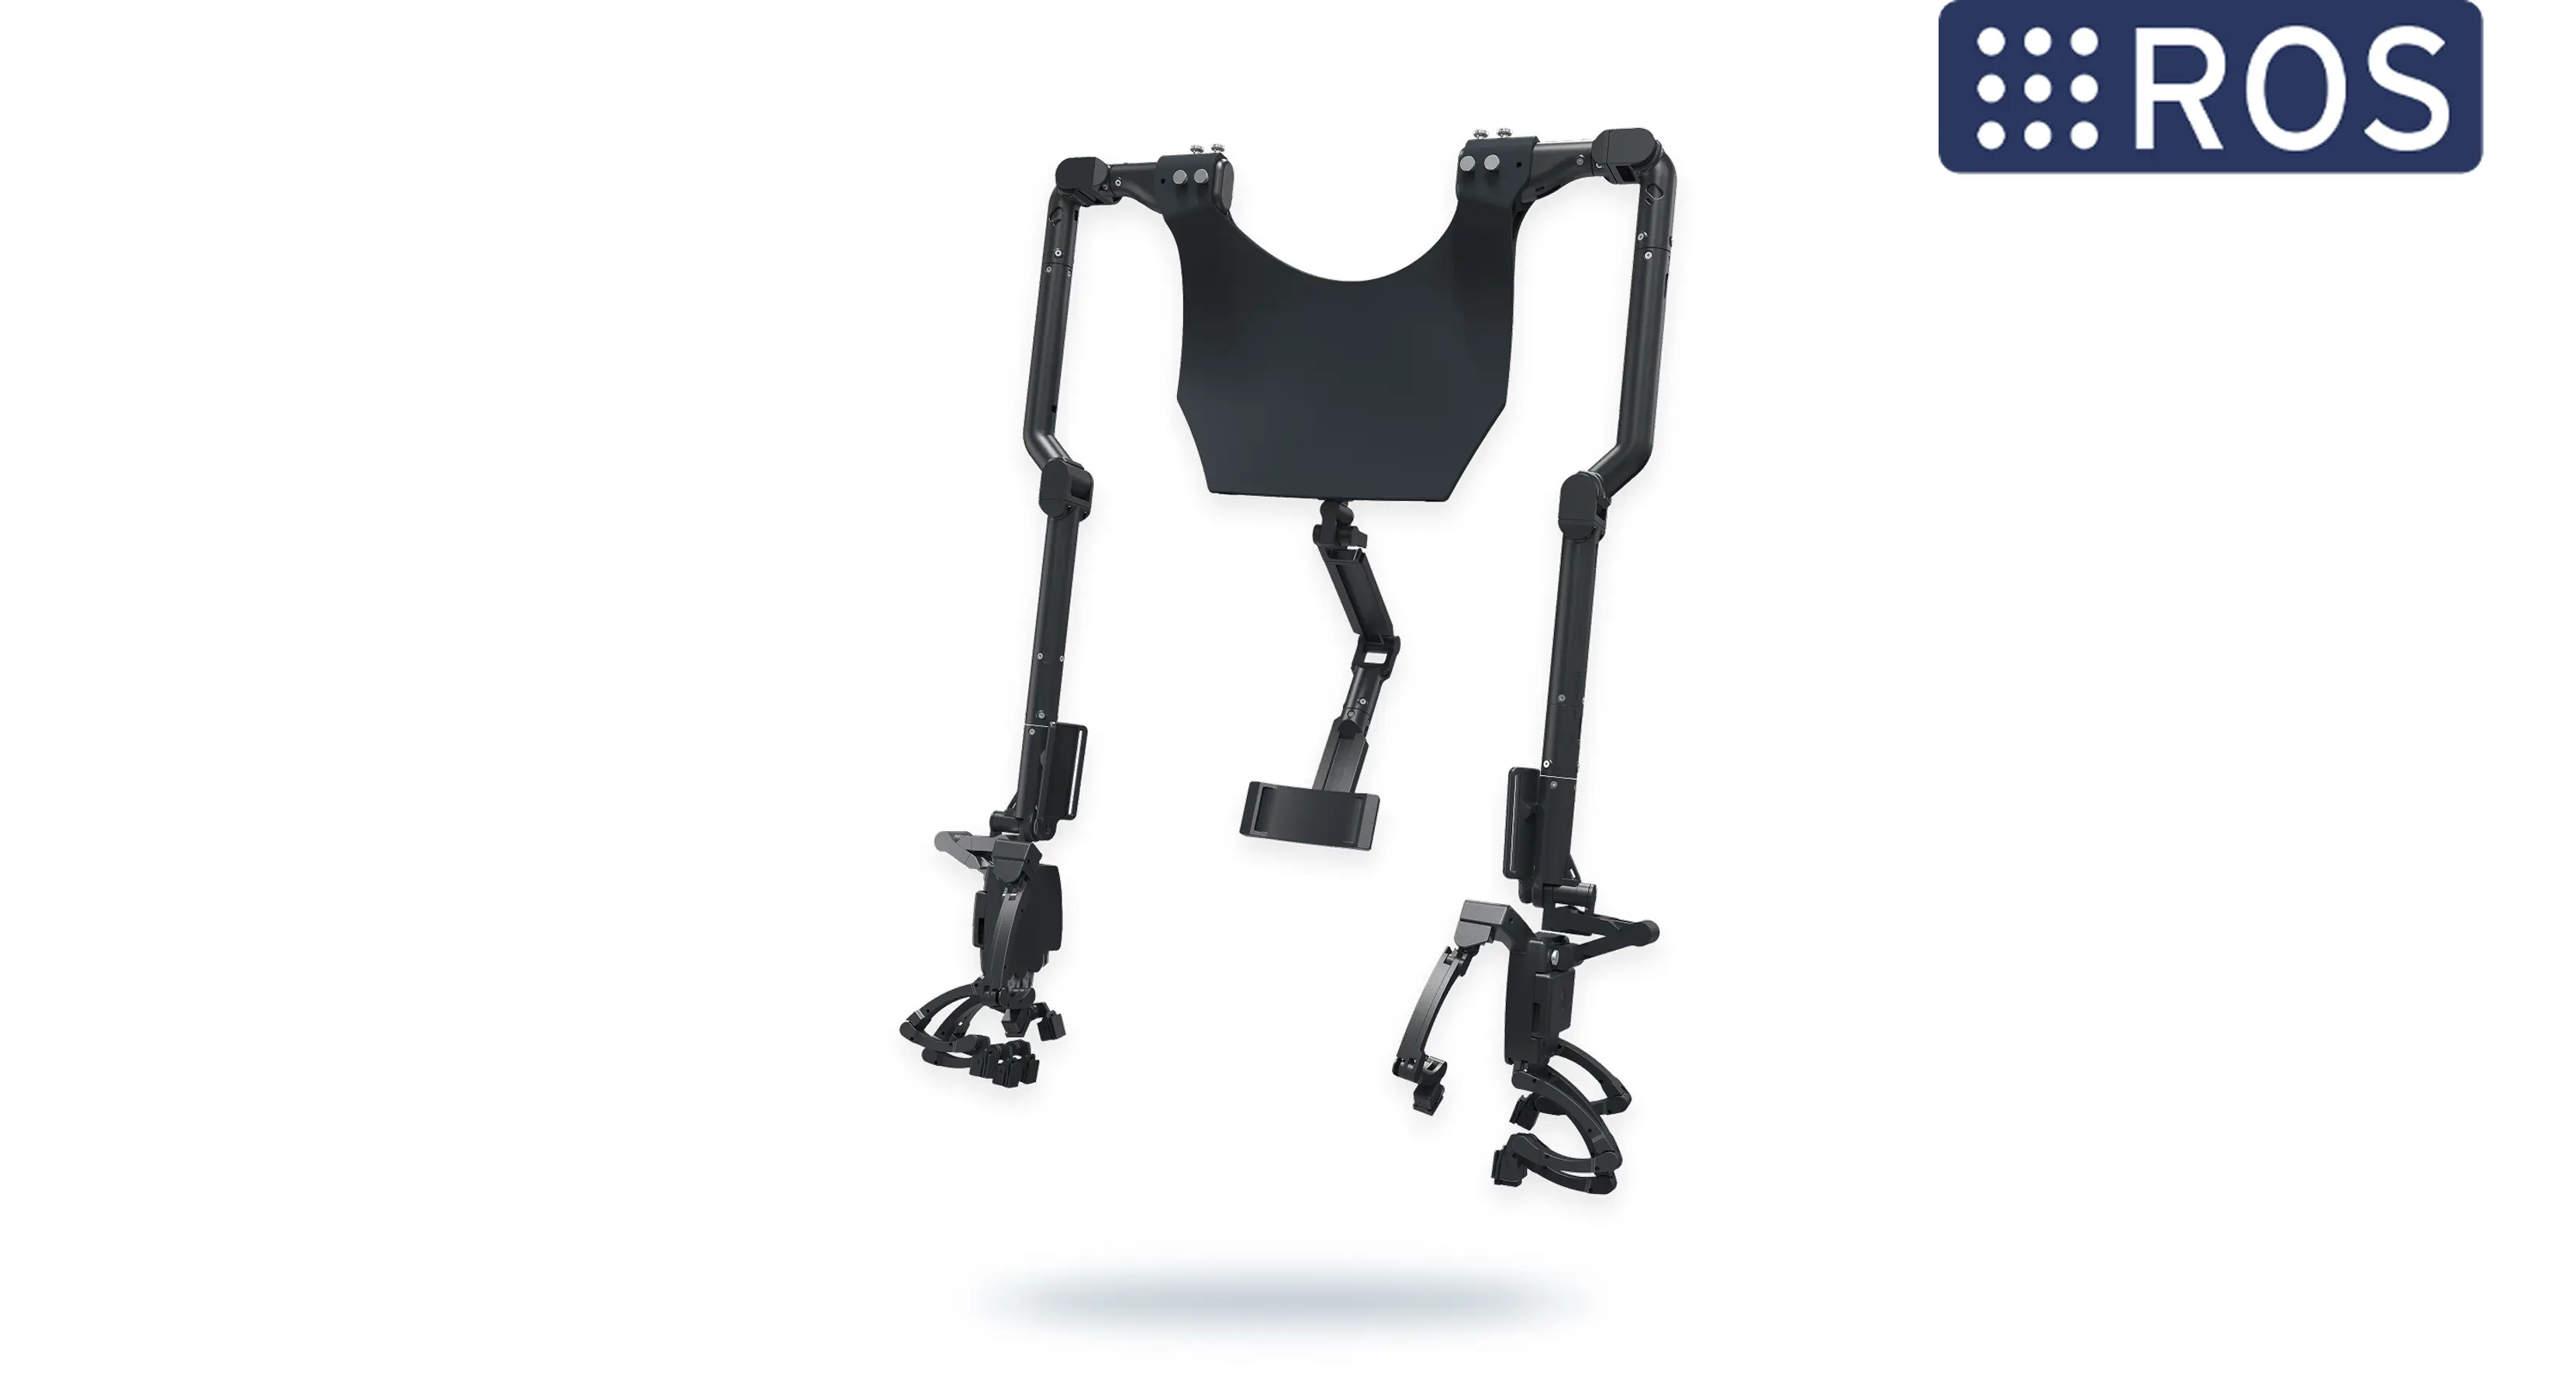
🔗 데이터가 적을수록 정밀하게 모으는 DexCap
DexCap은 팔과 손 그리고 허리까지 65 자유도를 65개 절대 엔코더로 추적하는 착용형 외골격 장비입니다. 데이터 수집과 텔레오퍼레이션을 한 장비로 할 수 있습니다. 밀리미터급 정밀도에 유선 기준 최대 1000Hz로 데이터를 보내서 사람의 상체 동작을 그대로 로봇 시연 데이터로 옮길 수 있습니다. C++과 Python 그리고 ROS SDK를 지원해 주요 로봇팔과 덱스터러스 핸드에 연결됩니다. 협동로봇 한 대를 텔레오퍼레이션하는 실험부터 휴머노이드 상체 데이터 수집까지 같은 장비로 해볼 수 있어요.
DexCap 자세히 보기 >두 번째 한계였던 힘과 회전은 경로를 아무리 잘 그려도 해결되지 않습니다. 결국 하위 정책이 손끝에서 직접 읽어야 합니다. 경로는 손이 어디로 갈지를 알려줄 뿐이고 얼마나 세게 어느 각도로 쥘지는 손이 느껴야 압니다.
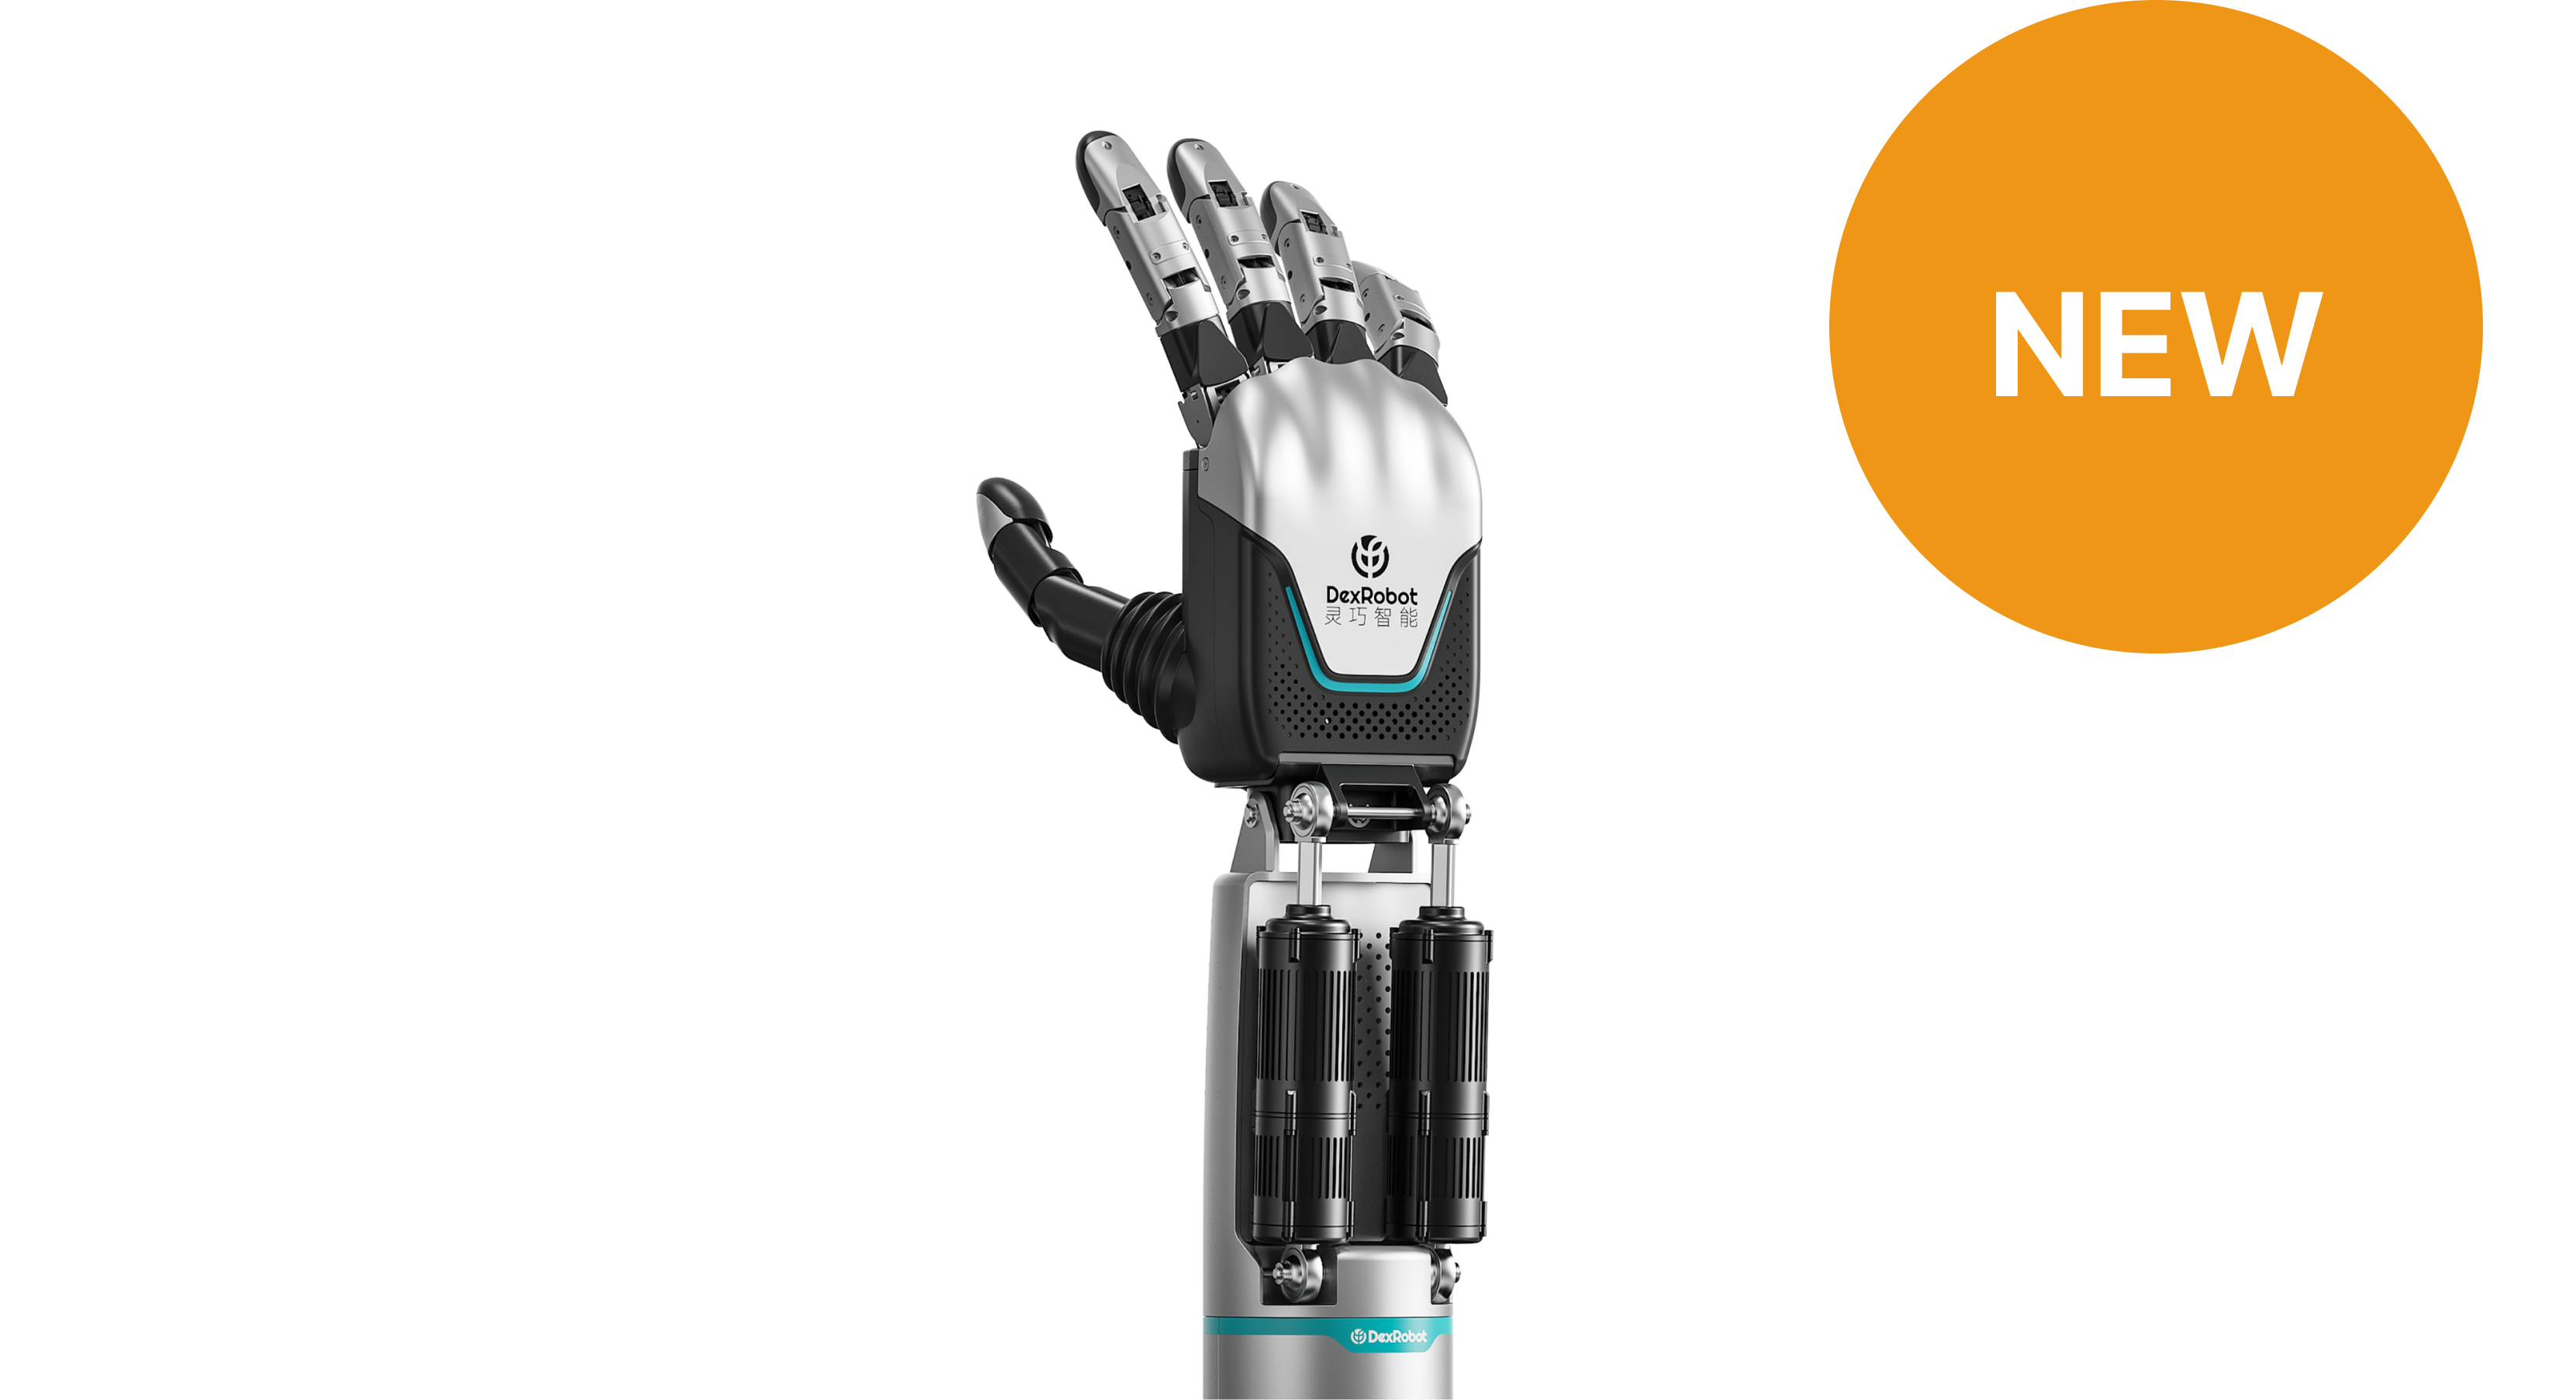
🔗 경로에 담기지 않는 힘을 읽는 손 DexHand021 Pro
손목과 손이 하나로 통합된 22 자유도(능동 18) 텐던 구동 덱스터러스 핸드입니다. 손끝과 손가락 패드 그리고 손바닥에 걸쳐 400개가 넘는 촉각 유닛이 들어 있고 20개 관절 센서와 5MP 카메라도 내장돼 있습니다. 상위 모델이 정해준 경로를 따라가면서 접촉력과 미끄러짐을 읽어내는 하위 정책 연구에 잘 맞습니다. 사람 손 형태의 기본형부터 시작하고 싶다면 19 자유도 양산형 DexHand021 MP도 같이 검토해 보세요.
DexHand021 Pro 자세히 보기 >HAMSTER의 구성 요소를 연구실에 필요한 장비로 바꿔보면 아래와 같습니다. 상위 VLM 쪽은 공개 데이터셋으로 해결되고 직접 갖춰야 하는 건 대부분 하위 정책 쪽입니다.
| HAMSTER 구성 요소 | 연구실에 실제로 필요한 것 |
|---|---|
| 상위 VLM 파인튜닝 | 학습용 GPU 서버. 논문은 VILA-1.5-13B 전체를 A100 8장으로 약 30시간 학습했음. 부록 실험에서는 30억 파라미터급 모델도 단순화한 경로로 학습하면 경로를 잘 예측해서 더 작은 환경으로 시작해볼 수 있음 |
| 오프도메인 데이터 | RoboPoint / RLBench / Bridge / DROID 같은 공개 데이터셋. 직접 수집할 필요 없음 |
| 하위 3D 정책 입력 | 포인트클라우드를 만들 depth 카메라와 RVT-2나 3D Diffuser Actor 같은 오픈소스 3D 정책 |
| 실제 로봇 시연 데이터 (320 에피소드) | SDK가 공개된 연구용 협동로봇 팔과 텔레오퍼레이션 장비 |
| 힘과 회전 정보 (한계 보완) | 접촉력과 미끄러짐을 읽을 수 있는 촉각 센싱 덱스터러스 핸드 |
| 휴머노이드 상체 적용 (CTO 제안) | 휴머노이드 실기체와 로봇핸드 그리고 상체 동작을 수집할 텔레오퍼레이션 장비 |
🔬 이런 환경이 갖춰지면 이어갈 수 있는 후속 연구 주제
- HAMSTER와 ACT / Diffusion Policy 구조 비교
- 2D Path를 3D Action으로 변환하는 최적의 representation 연구
- Human Video를 활용한 Robot-free VLA 학습
- Simulation에서 Real Robot으로 가는 off-domain transfer
- 2D Path 대신 3D Waypoint / 3D Pointmap을 intermediate representation으로 쓰는 방법
- HAMSTER 구조를 휴머노이드 양팔 조작에 적용
- VLM의 semantic planning과 VLA의 low-level control을 비동기로 실행하는 구조
- GR00T / OpenVLA 계열과 hierarchical VLA의 데이터 효율성 비교
06마치며
하나의 거대한 모델에서, 역할을 나누는 구조로
HAMSTER는 VLM과 imitation learning을 단순히 이어 붙인 연구가 아닙니다. VLM이 잘하는 영역과 로봇 정책이 잘하는 영역을 나누고 그 사이를 2D Path라는 중간 표현으로 연결했습니다. VLM은 이미지와 언어를 보고 무엇을 해야 하는지와 손이 어느 방향으로 가야 하는지를 이해합니다. 하위 정책은 depth와 3D geometry 그리고 로봇의 현재 상태를 이용해 그 움직임을 실제 action으로 바꿉니다. 거대한 모델 하나가 모든 걸 해결하던 방식에서 역할을 나누고 서로 다른 데이터를 활용하는 방식으로 넘어가는 흐름이라고 볼 수 있습니다.
로봇 분야는 늘 실제 로봇 데이터가 부족합니다. HAMSTER는 로봇 데이터를 더 많이 모으는 대신 시뮬레이션이나 다른 로봇의 데이터처럼 비교적 쉽게 얻을 수 있는 데이터를 중간 표현을 거쳐 쓰는 길을 열었습니다. 같은 구조라면 사람 영상까지 활용할 여지도 있습니다.
VLA가 모든 걸 혼자 다 할 필요는 없다.
VLM은 무엇을 어디로 옮길지 정하고
하위 정책은 그걸 어떻게 해낼지 정한다.
이 관점은 VLA를 실제 휴머노이드에 적용할 때 더 힘을 발휘할 것으로 봅니다. 휴머노이드는 관절 수가 많아서 VLM이 모든 관절의 action을 직접 만들게 하기가 매우 어렵습니다. HAMSTER처럼 상위 모델은 작업 목표와 공간적인 움직임을 정하고 하위 정책은 로봇의 형태와 dynamics에 맞춰 실제 움직임을 만들도록 나누면 하나의 상위 지능을 여러 로봇에 연결하는 구조를 만들 수 있습니다.
CTO 제안처럼 이 구조를 연구실에서 직접 돌려보려면 하위 정책을 올릴 로봇팔과 시연 데이터를 모을 장비가 필요합니다. 힘과 회전까지 다루려면 손끝에서 접촉을 읽는 로봇핸드도 있어야 하고요. 하위 정책이 손가락 단위 파지를 어떻게 다룰 수 있는지는 6편 FSAG 리뷰를 참고하시면 좋습니다(👉 6편 콘텐츠 확인하기). 마로솔 VLA 연구 패키지는 이번 글에서 소개한 장비로 이 구성을 한 번에 갖출 수 있게 준비한 패키지입니다.
MAROSOL VLA RESEARCH PACKAGE
마로솔 VLA 연구 패키지
계층형 VLA 연구에서 실제 로봇이 필요한 곳은 하위 정책입니다. 마로솔은 하위 정책을 올릴 협동로봇과 시연 데이터를 모을 텔레오퍼레이션 장비 그리고 접촉을 읽는 로봇핸드를 연구 목적에 맞게 묶고 초기 세팅까지 함께 제공합니다.
- UFACTORY xArm5 / xArm6 / xArm7
하위 정책을 학습시키고 실제 환경에서 검증할 연구용 협동로봇 - DexRobot DexCap
65 자유도 외골격으로 정밀한 시연 데이터 수집과 텔레오퍼레이션 - DexRobot DexHand021 MP
사람 손 형태의 19 자유도 기본형 덱스터러스 핸드 - DexRobot DexHand021 Pro
400개가 넘는 촉각 유닛으로 접촉력과 미끄러짐을 읽는 손목 일체형 핸드 - 초기 세팅과 도입 이후 기술 지원
로봇을 구매하는 것과 VLA를 연구할 수 있는 환경을 구축하는 것은 다릅니다.
마로솔은 협동로봇과 데이터 수집 장비 그리고 로봇핸드를 한 번에 구성해 도입 부담은 낮추고 연구 준비 속도는 높입니다. 계층형 VLA나 모방학습 연구 환경을 검토 중인 연구·교육기관이라면 목적과 예산에 맞는 구성과 조건을 함께 제안드립니다.
MAROSOL G1 EDU RESEARCH PACKAGE
마로솔 G1 Edu 연구 패키지
마로솔은 Unitree G1 Edu 공급을 넘어 피지컬 AI 연구에 필요한 데이터와 제어 그리고 안전 환경까지 통합 구축하는 연구 인프라 파트너입니다. 기관별 연구 목적에 맞춰 G1 Edu와 휴머노이드 데이터 매니저 솔루션을 기본으로 덱스터러스 핸드와 텔레오퍼레이션 장비 같은 연구 필수 장비와 초기 세팅까지 하나의 패키지로 제공합니다.
- 연구 목적별 G1 Edu 구성
- 데이터 매니저 솔루션 결합으로 G1 데이터 수집·관리 환경 구축
- 덱스터러스 핸드와 텔레오퍼레이션 그리고 VR 장비 연계
- 안전장비 및 초기 세팅 지원
- 도입 이후 기술 지원
G1을 구매하는 것과 G1으로 연구할 수 있는 환경을 구축하는 것은 다릅니다.
마로솔은 G1 Edu와 데이터 매니저 그리고 연구 필수 장비를 결합해 도입 부담은 낮추고 연구 준비 속도는 높입니다. 계층형 VLA 연구나 피지컬 AI 연구 환경 구축을 검토 중인 연구·교육기관이라면 목적과 예산에 맞는 구성과 조건을 함께 제안드립니다.
📎 함께 보면 좋은 콘텐츠
- [CTO's Pick #1] 휴머노이드에게 사람의 손재주를 가르칠 수 있을까? HumDex 논문 리뷰
- [CTO's Pick #2] 휴머노이드는 왜 매번 처음부터 배워야 할까? SkillBlender 논문 리뷰
- [CTO's Pick #3] 휴머노이드는 자기 눈으로 물체를 볼 수 있을까? VisualMimic 논문 리뷰
- [CTO's Pick #4] 휴머노이드 VLA 학습 데이터, 이제 시뮬레이션으로 만든다. 스탠퍼드 LEGS 논문 분석
- [CTO's Pick #5] 모방학습 로봇은 사람 시연보다 빨라질 수 없을까? RACE 논문 리뷰
- [CTO's Pick #6] 덱스터러스 핸드는 왜 드릴을 못 잡을까? 손가락별 어포던스로 로봇 손 파지를 푼 FSAG 논문 리뷰
- 마로솔 휴머노이드 스토어 전체 라인업 보기
출처
- 논문 : HAMSTER: Hierarchical Action Models For Open-World Robot Manipulation, Yi Li, Yuquan Deng, Jesse Zhang, Joel Jang, Marius Memmel, Raymond Yu, Caelan Reed Garrett, Fabio Ramos, Dieter Fox, Anqi Li, Abhishek Gupta, Ankit Goyal, ICLR 2025, arXiv:2502.05485
- 프로젝트 페이지 : HAMSTER Project Page
- 후속 연구 : 3D HAMSTER: Bridging Planning and Control in Hierarchical Vision Language Action Models through 3D Trajectory Guidance, arXiv:2606.31329
- 본문에 사용된 논문 이미지와 수식의 저작권은 원저자에게 있으며 연구 소개 목적으로 인용되었습니다.